#sdsc6015

English / 中文

回顾

点击展开

凸优化问题

凸优化问题的一般形式为:

min⁡x∈Rdf(x)\min_{x \in \mathbb{R}^d} f(x)

其中 ff 是凸函数,Rd\mathbb{R}^d 是凸集,x∗x^* 是其最小化点:

x∗=arg⁡min⁡x∈Rdf(x)x^* = \arg\min_{x \in \mathbb{R}^d} f(x)

梯度下降(Gradient Descent, GD)的更新规则为:

xk+1=xk−ηk+1∇f(xk)x_{k+1} = x_k - \eta_{k+1} \nabla f(x_k)

  • xkx_k:当前参数点

  • ηk>0\eta_k > 0:步长(学习率)

  • xk+1x_{k+1}:更新后的参数点


平滑函数(Smooth Functions)

定义:

若函数 f:dom(f)→Rf: \text{dom}(f) \to \mathbb{R} 可微,且存在 L>0L > 0,使得对所有 x,y∈X⊆dom(f)x, y \in X \subseteq \text{dom}(f) 有:

f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥x−y∥2f(y) \leq f(x) + \nabla f(x)^\top (y - x) + \frac{L}{2} \|x - y\|^2

则称 ff 是**LL-平滑的**。

💡 平滑性意味着函数的梯度变化不会太快,上界由 LL 控制。


次梯度(Subgradient)

定义:

对于凸函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R},在点 xx 处的次梯度 gg 满足:

f(y)≥f(x)+g⊤(y−x),∀yf(y) \geq f(x) + g^\top (y - x), \quad \forall y

所有次梯度的集合称为次微分:

∂f(x)={g∈Rd∣g 是 f 在 x 处的次梯度}\partial f(x) = \{ g \in \mathbb{R}^d \mid g \text{ 是 } f \text{ 在 } x \text{ 处的次梯度} \}

🔍 对于可微凸函数,次微分就是梯度;对于不可微函数(如 ∣x∣|x|),次梯度可能不唯一。

次梯度方法:

更新规则为:

xk+1=xk−ηk+1gk,gk∈∂f(xk)x_{k+1} = x_k - \eta_{k+1} g_k, \quad g_k \in \partial f(x_k)

  • 注意:次梯度方法不一定是下降方法(例如 f(x)=∣x∣f(x) = |x| 可能产生振荡)。


收敛性能对比表

函数性质 算法 收敛界 迭代次数(达到误差 ε\varepsilon)
Convex, LL-Lipschitz GD f(xbest(T))−f(x∗)≤RLTf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{RL}{\sqrt{T}} O(R2L2ε2)\mathcal{O}\left( \frac{R^2 L^2}{\varepsilon^2} \right)
Convex, LL-Smooth GD f(xbest(T))−f(x∗)≤R2L2Tf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{R^2 L}{2T} O(R2L2ε)\mathcal{O}\left( \frac{R^2 L}{2\varepsilon} \right)
μ\mu-SC, LL-Smooth GD f(xbest(T))−f(x∗)≤L2(1−μL)TR2f(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{L}{2} \left(1 - \frac{\mu}{L}\right)^T R^2 O(Lμln⁡R2L2ε)\mathcal{O}\left( \frac{L}{\mu} \ln \frac{R^2 L}{2\varepsilon} \right)
Convex, LL-Lipschitz Subgradient f(xbest(T))−f(x∗)≤LRTf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{LR}{\sqrt{T}} O(R2L2ε2)\mathcal{O}\left( \frac{R^2 L^2}{\varepsilon^2} \right)
μ\mu-SC, ∣g∣≤B|g| \leq B Subgradient f(xbest(T))−f(x∗)≤2B2μ(T+1)f(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{2B^2}{\mu(T+1)} O(2B2με)\mathcal{O}\left( \frac{2B^2}{\mu\varepsilon} \right)

其中:

  • R=∥x0−x∗∥R = \|x_0 - x^*\|

  • xbest(T)=arg⁡min⁡i=0,…,Tf(xi)x_{\text{best}}^{(T)} = \arg\min_{i=0,\dots,T} f(x_i)


强凸函数(Strongly Convex Functions)

定义

一个函数 f:dom(f)→Rf: \text{dom}(f) \to \mathbb{R} 被称为强凸函数(strongly convex),如果存在参数 μ>0\mu > 0,使得对于所有 x,y∈dom(f)x, y \in \text{dom}(f)(其中 dom(f)\text{dom}(f) 是凸集),都有:

f(y)≥f(x)+∇f(x)⊤(y−x)+μ2∥y−x∥2f(y) \geq f(x) + \nabla f(x)^\top (y - x) + \frac{\mu}{2} \|y - x\|^2

截屏2025-09-22 17.53.13.png

这里,∇f(x)\nabla f(x) 是 ff 在点 xx 处的梯度(如果 ff 可微)。

对于不可微函数,次梯度版本的定义为:对于所有 g∈∂f(x)g \in \partial f(x)(次微分),有:

f(y)≥f(x)+g⊤(y−x)+μ2∥y−x∥2f(y) \geq f(x) + g^\top (y - x) + \frac{\mu}{2} \|y - x\|^2

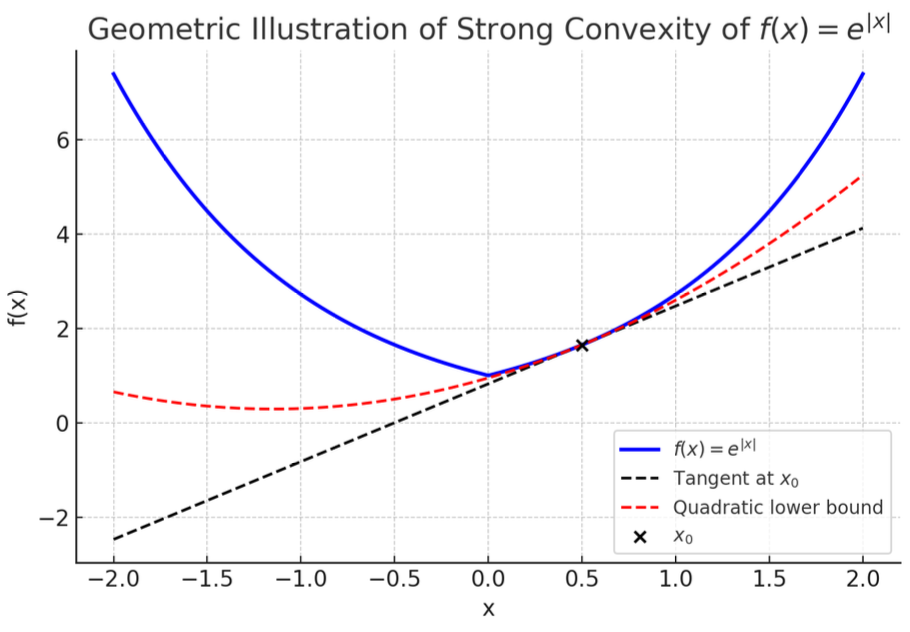
💡 直观解释:强凸函数在任意点 xx 处,其函数值都高于一个“加强的”线性近似(即加上一个二次项 μ2∥y−x∥2\frac{\mu}{2} \|y - x\|^2)。这确保了函数具有更强的曲率,从而优化时收敛更快。

关键性质

(1)强凸性蕴含严格凸性

如果 ff 是 μ\mu-强凸的,那么它也是严格凸的。这意味着对于所有 x≠yx \neq y 和 λ∈(0,1)\lambda \in (0,1),有:

f(λx+(1−λ)y)<λf(x)+(1−λ)f(y)f(\lambda x + (1-\lambda) y) < \lambda f(x) + (1-\lambda) f(y)

证明概要(来自补充笔记 p15):
假设 x≠yx \neq y,令 z=λx+(1−λ)yz = \lambda x + (1-\lambda) y。由强凸性:

f(x)>f(z)+∇f(z)⊤(x−z)f(y)>f(z)+∇f(z)⊤(y−z)\begin{aligned} f(x) &> f(z) + \nabla f(z)^\top (x - z) \\ f(y) &> f(z) + \nabla f(z)^\top (y - z) \end{aligned}

将这两个不等式加权平均(权重为 λ\lambda 和 1−λ1-\lambda),梯度项抵消,得到:

λf(x)+(1−λ)f(y)>f(z)\lambda f(x) + (1-\lambda) f(y) > f(z)

从而证得严格凸性。

(2)存在唯一全局最小值

强凸函数有且仅有一个全局最小值点 x∗x^*。
证明概要(来自补充笔记 p15):
假设 x∗x^* 是最小点,则 ∇f(x∗)=0\nabla f(x^*) = 0(可微情况)或 0∈∂f(x∗)0 \in \partial f(x^*)(不可微情况)。由强凸性:

f(y)≥f(x∗)+μ2∥y−x∗∥2f(y) \geq f(x^*) + \frac{\mu}{2} \|y - x^*\|^2

当 y≠x∗y \neq x^* 时,μ2∥y−x∗∥2>0\frac{\mu}{2} \|y - x^*\|^2 > 0,因此 f(y)>f(x∗)f(y) > f(x^*),即 x∗x^* 是唯一的。

例子

强凸函数的一个典型例子是 f(x)=e∣x∣f(x) = e^{|x|},它对于某些参数 μ\mu 是强凸的。具体地,当 μ=1\mu = 1 时,该函数满足强凸定义。

截屏2025-09-22 17.51.53.png

在优化中的应用

强凸性显著改善了优化算法的收敛速率。以下分两种情况讨论:

(1)梯度下降(Gradient Descent)用于平滑且强凸的函数

如果 ff 是 LL-平滑且 μ\mu-强凸的(即可微),则选择步长 η=1L\eta = \frac{1}{L},梯度下降的迭代点满足:

∥xt+1−x∗∥2≤(1−μL)∥xt−x∗∥2\|x_{t+1} - x^*\|^2 \leq \left(1 - \frac{\mu}{L} \right) \|x_t - x^*\|^2

误差按指数衰减:

f(xT)−f(x∗)≤L2(1−μL)T∥x0−x∗∥2f(x_T) - f(x^*) \leq \frac{L}{2} \left(1 - \frac{\mu}{L} \right)^T \|x_0 - x^*\|^2

证明:

从梯度下降更新:xt+1=xt−η∇f(xt)x_{t+1} = x_t - \eta \nabla f(x_t)。
考虑距离变化:

∥xt+1−x∗∥2=∥xt−η∇f(xt)−x∗∥2=∥xt−x∗∥2−2η∇f(xt)⊤(xt−x∗)+η2∥∇f(xt)∥2\|x_{t+1} - x^*\|^2 = \|x_t - \eta \nabla f(x_t) - x^*\|^2 = \|x_t - x^*\|^2 - 2\eta \nabla f(x_t)^\top (x_t - x^*) + \eta^2 \|\nabla f(x_t)\|^2

由强凸性:

∇f(xt)⊤(xt−x∗)≥f(xt)−f(x∗)+μ2∥xt−x∗∥2\nabla f(x_t)^\top (x_t - x^*) \geq f(x_t) - f(x^*) + \frac{\mu}{2} \|x_t - x^*\|^2

代入:

∥xt+1−x∗∥2≤∥xt−x∗∥2−2η(f(xt)−f(x∗)+μ2∥xt−x∗∥2)+η2∥∇f(xt)∥2\|x_{t+1} - x^*\|^2 \leq \|x_t - x^*\|^2 - 2\eta \left( f(x_t) - f(x^*) + \frac{\mu}{2} \|x_t - x^*\|^2 \right) + \eta^2 \|\nabla f(x_t)\|^2

整理:

∥xt+1−x∗∥2≤(1−μη)∥xt−x∗∥2−2η(f(xt)−f(x∗))+η2∥∇f(xt)∥2\|x_{t+1} - x^*\|^2 \leq (1 - \mu \eta) \|x_t - x^*\|^2 - 2\eta (f(x_t) - f(x^*)) + \eta^2 \|\nabla f(x_t)\|^2

现在取 η=1/L\eta = 1/L。由平滑性,有充分下降引理:

f(xt+1)≤f(xt)−12L∥∇f(xt)∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2

因此,−12L∥∇f(xt)∥2≤f(xt+1)−f(xt)-\frac{1}{2L} \|\nabla f(x_t)\|^2 \leq f(x_{t+1}) - f(x_t),但这里我们需要 bound η2∥∇f(xt)∥2\eta^2 \|\nabla f(x_t)\|^2。

实际上,从平滑性,有:

f(x∗)≤f(xt)−12L∥∇f(xt)∥2f(x^*) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2

所以 ∥∇f(xt)∥2≤2L(f(xt)−f(x∗))\|\nabla f(x_t)\|^2 \leq 2L (f(x_t) - f(x^*))。

代入:

η2∥∇f(xt)∥2=1L2∥∇f(xt)∥2≤2L(f(xt)−f(x∗))\eta^2 \|\nabla f(x_t)\|^2 = \frac{1}{L^2} \|\nabla f(x_t)\|^2 \leq \frac{2}{L} (f(x_t) - f(x^*))

于是:

∥xt+1−x∗∥2≤(1−μη)∥xt−x∗∥2−2η(f(xt)−f(x∗))+2L(f(xt)−f(x∗))\|x_{t+1} - x^*\|^2 \leq (1 - \mu \eta) \|x_t - x^*\|^2 - 2\eta (f(x_t) - f(x^*)) + \frac{2}{L} (f(x_t) - f(x^*))

由于 η=1/L\eta = 1/L,−2η+2L=0-2\eta + \frac{2}{L} = 0,所以:

∥xt+1−x∗∥2≤(1−μL)∥xt−x∗∥2\|x_{t+1} - x^*\|^2 \leq (1 - \frac{\mu}{L}) \|x_t - x^*\|^2

这证明了第一部分。

对于第二部分,由平滑性:

f(xT)−f(x∗)≤L2∥xT−x∗∥2≤L2(1−μL)T∥x0−x∗∥2f(x_T) - f(x^*) \leq \frac{L}{2} \|x_T - x^*\|^2 \leq \frac{L}{2} \left(1 - \frac{\mu}{L}\right)^T \|x_0 - x^*\|^2

证毕。

迭代次数需求:要达到误差 ε\varepsilon,需要迭代次数为:

T≥Lμln⁡(R2L2ε),其中 R=∥x0−x∗∥T \geq \frac{L}{\mu} \ln \left( \frac{R^2 L}{2\varepsilon} \right), \quad \text{其中 } R = \|x_0 - x^*\|

这比非强凸情况(如平滑凸函数的 O(1/ε)\mathcal{O}(1/\varepsilon) 速率)快得多,因为误差以 O(e−T)\mathcal{O}(e^{-T}) 衰减。

(2)次梯度方法(Subgradient Method)用于强凸函数

如果 ff 是 μ\mu-强凸的(可能不可微),且次梯度范数有界(即 ∥gt∥≤B\|g_t\| \leq B 对于所有 gt∈∂f(xt)g_t \in \partial f(x_t)),则采用递减步长:

ηt=2μ(t+1)\eta_t = \frac{2}{\mu(t + 1)}

并计算加权平均点:

xˉT=2T(T+1)∑t=1Tt⋅xt\bar{x}_T = \frac{2}{T(T+1)} \sum_{t=1}^T t \cdot x_t

则收敛速率为:

f(xˉT)−f(x∗)≤2B2μ(T+1)f(\bar{x}_T) - f(x^*) \leq \frac{2B^2}{\mu(T + 1)}

证明:

从次梯度更新:xt+1=xt−ηtgtx_{t+1} = x_t - \eta_t g_t,其中 gt∈∂f(xt)g_t \in \partial f(x_t)。
考虑距离变化:

∥xt+1−x∗∥2=∥xt−ηtgt−x∗∥2=∥xt−x∗∥2−2ηtgt⊤(xt−x∗)+ηt2∥gt∥2\|x_{t+1} - x^*\|^2 = \|x_t - \eta_t g_t - x^*\|^2 = \|x_t - x^*\|^2 - 2\eta_t g_t^\top (x_t - x^*) + \eta_t^2 \|g_t\|^2

由强凸性:

gt⊤(xt−x∗)≥f(xt)−f(x∗)+μ2∥xt−x∗∥2g_t^\top (x_t - x^*) \geq f(x_t) - f(x^*) + \frac{\mu}{2} \|x_t - x^*\|^2

代入:

∥xt+1−x∗∥2≤∥xt−x∗∥2−2ηt(f(xt)−f(x∗)+μ2∥xt−x∗∥2)+ηt2∥gt∥2\|x_{t+1} - x^*\|^2 \leq \|x_t - x^*\|^2 - 2\eta_t \left( f(x_t) - f(x^*) + \frac{\mu}{2} \|x_t - x^*\|^2 \right) + \eta_t^2 \|g_t\|^2

整理:

∥xt+1−x∗∥2≤(1−μηt)∥xt−x∗∥2−2ηt(f(xt)−f(x∗))+ηt2B2\|x_{t+1} - x^*\|^2 \leq (1 - \mu \eta_t) \|x_t - x^*\|^2 - 2\eta_t (f(x_t) - f(x^*)) + \eta_t^2 B^2

现在移项:

2ηt(f(xt)−f(x∗))≤(1−μηt)∥xt−x∗∥2−∥xt+1−x∗∥2+ηt2B22\eta_t (f(x_t) - f(x^*)) \leq (1 - \mu \eta_t) \|x_t - x^*\|^2 - \|x_{t+1} - x^*\|^2 + \eta_t^2 B^2

代入步长 ηt=2μ(t+1)\eta_t = \frac{2}{\mu(t+1)},则 1−μηt=1−2t+1=t−1t+11 - \mu \eta_t = 1 - \frac{2}{t+1} = \frac{t-1}{t+1}。

两边乘以 tt(为了 telescoping):

2tηt(f(xt)−f(x∗))≤t(1−μηt)∥xt−x∗∥2−t∥xt+1−x∗∥2+tηt2B22t \eta_t (f(x_t) - f(x^*)) \leq t(1 - \mu \eta_t) \|x_t - x^*\|^2 - t \|x_{t+1} - x^*\|^2 + t \eta_t^2 B^2

注意 t(1−μηt)=t⋅t−1t+1=t(t−1)t+1t(1 - \mu \eta_t) = t \cdot \frac{t-1}{t+1} = \frac{t(t-1)}{t+1},且 tηt2=t⋅4μ2(t+1)2=4tμ2(t+1)2t \eta_t^2 = t \cdot \frac{4}{\mu^2 (t+1)^2} = \frac{4t}{\mu^2 (t+1)^2}。

但更直接的是,观察:

t(1−μηt)=t(t−1)t+1,而(t+1)∥xt+1−x∗∥2可能出现t(1 - \mu \eta_t) = \frac{t(t-1)}{t+1}, \quad \text{而} \quad (t+1) \|x_{t+1} - x^*\|^2 \text{可能出现}

实际上,从原不等式:

2ηt(f(xt)−f(x∗))≤ηt2B22+12ηt(∥xt−x∗∥2−∥xt+1−x∗∥2)−μ2∥xt−x∗∥22\eta_t (f(x_t) - f(x^*)) \leq \frac{\eta_t^2 B^2}{2} + \frac{1}{2\eta_t} \left( \|x_t - x^*\|^2 - \|x_{t+1} - x^*\|^2 \right) - \frac{\mu}{2} \|x_t - x^*\|^2

但课程材料中采用了另一种方式。

根据课程材料证明:
从不等式:

f(xt)−f(x∗)≤B2ηt2+ηt−1−μ2∥xt−x∗∥2−ηt−12∥xt+1−x∗∥2f(x_t) - f(x^*) \leq \frac{B^2 \eta_t}{2} + \frac{\eta_t^{-1} - \mu}{2} \|x_t - x^*\|^2 - \frac{\eta_t^{-1}}{2} \|x_{t+1} - x^*\|^2

代入 ηt=2μ(t+1)\eta_t = \frac{2}{\mu(t+1)},则 ηt−1=μ(t+1)2\eta_t^{-1} = \frac{\mu(t+1)}{2}。

所以:

f(xt)−f(x∗)≤B22⋅2μ(t+1)+12(μ(t+1)2−μ)∥xt−x∗∥2−12⋅μ(t+1)2∥xt+1−x∗∥2f(x_t) - f(x^*) \leq \frac{B^2}{2} \cdot \frac{2}{\mu(t+1)} + \frac{1}{2} \left( \frac{\mu(t+1)}{2} - \mu \right) \|x_t - x^*\|^2 - \frac{1}{2} \cdot \frac{\mu(t+1)}{2} \|x_{t+1} - x^*\|^2

简化:

f(xt)−f(x∗)≤B2μ(t+1)+μ4((t+1)−2)∥xt−x∗∥2−μ(t+1)4∥xt+1−x∗∥2f(x_t) - f(x^*) \leq \frac{B^2}{\mu(t+1)} + \frac{\mu}{4} \left( (t+1) - 2 \right) \|x_t - x^*\|^2 - \frac{\mu(t+1)}{4} \|x_{t+1} - x^*\|^2

即:

f(xt)−f(x∗)≤B2μ(t+1)+μ4(t−1)∥xt−x∗∥2−μ(t+1)4∥xt+1−x∗∥2f(x_t) - f(x^*) \leq \frac{B^2}{\mu(t+1)} + \frac{\mu}{4} (t-1) \|x_t - x^*\|^2 - \frac{\mu(t+1)}{4} \|x_{t+1} - x^*\|^2

两边乘以 tt:

t(f(xt)−f(x∗))≤tB2μ(t+1)+μ4(t(t−1)∥xt−x∗∥2−t(t+1)∥xt+1−x∗∥2)t (f(x_t) - f(x^*)) \leq \frac{t B^2}{\mu(t+1)} + \frac{\mu}{4} \left( t(t-1) \|x_t - x^*\|^2 - t(t+1) \|x_{t+1} - x^*\|^2 \right)

对 t=1t=1 到 TT 求和:

∑t=1Tt(f(xt)−f(x∗))≤∑t=1TtB2μ(t+1)+μ4(∑t=1T[t(t−1)∥xt−x∗∥2−t(t+1)∥xt+1−x∗∥2])\sum_{t=1}^T t (f(x_t) - f(x^*)) \leq \sum_{t=1}^T \frac{t B^2}{\mu(t+1)} + \frac{\mu}{4} \left( \sum_{t=1}^T [t(t-1) \|x_t - x^*\|^2 - t(t+1) \|x_{t+1} - x^*\|^2] \right)

右边第二项是 telescoping 和:

∑t=1T[t(t−1)∥xt−x∗∥2−t(t+1)∥xt+1−x∗∥2]=−T(T+1)∥xT+1−x∗∥2≤0\sum_{t=1}^T [t(t-1) \|x_t - x^*\|^2 - t(t+1) \|x_{t+1} - x^*\|^2] = - T(T+1) \|x_{T+1} - x^*\|^2 \leq 0

因为 t=1t=1 时 1⋅0⋅∥x1−x∗∥2=01 \cdot 0 \cdot \|x_1 - x^*\|^2 = 0,之后项抵消。

所以:

∑t=1Tt(f(xt)−f(x∗))≤∑t=1TtB2μ(t+1)≤TB2μ\sum_{t=1}^T t (f(x_t) - f(x^*)) \leq \sum_{t=1}^T \frac{t B^2}{\mu(t+1)} \leq \frac{T B^2}{\mu}

由凸性,加权平均满足:

f(2T(T+1)∑t=1Ttxt)≤2T(T+1)∑t=1Ttf(xt)f\left( \frac{2}{T(T+1)} \sum_{t=1}^T t x_t \right) \leq \frac{2}{T(T+1)} \sum_{t=1}^T t f(x_t)

所以:

f(2T(T+1)∑t=1Ttxt)−f(x∗)≤2T(T+1)∑t=1Tt(f(xt)−f(x∗))≤2T(T+1)⋅TB2μ=2B2μ(T+1)f\left( \frac{2}{T(T+1)} \sum_{t=1}^T t x_t \right) - f(x^*) \leq \frac{2}{T(T+1)} \sum_{t=1}^T t (f(x_t) - f(x^*)) \leq \frac{2}{T(T+1)} \cdot \frac{T B^2}{\mu} = \frac{2 B^2}{\mu (T+1)}

证毕。

迭代次数需求:要达到误差 ε\varepsilon,需要迭代次数为 O(B2με)\mathcal{O}\left( \frac{B^2}{\mu \varepsilon} \right)。

🔍 *注意:加权平均有助于稳定收敛,避免次梯度振荡。但次梯度方法不是下降方法,因此平均化是必要的。


投影梯度下降 (Projected Gradient Descent)

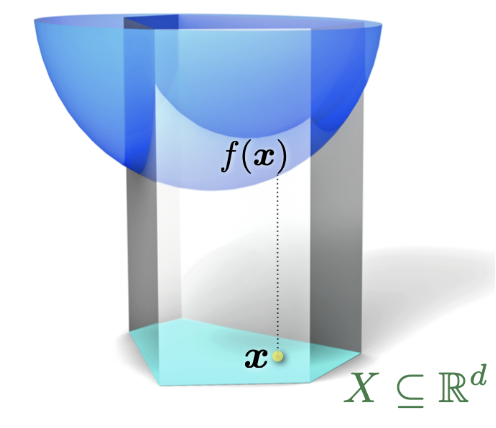
约束优化问题

min⁡x∈Xf(x)\min_{x \in X} f(x)

其中 X⊆RdX \subseteq \mathbb{R}^d 是闭凸集。

截屏2025-09-22 18.27.11.png

投影算子

投影 onto XX 定义为:

ΠX(y)=arg⁡min⁡x∈X∥x−y∥\Pi_X(y) = \arg\min_{x \in X} \|x - y\|

截屏2025-09-22 18.29.51.png

更新规则

yt+1=xt−ηt∇f(xt)xt+1=ΠX(yt+1)\begin{aligned} y_{t+1} &= x_t - \eta_t \nabla f(x_t) \\ x_{t+1} &= \Pi_X(y_{t+1}) \end{aligned}

投影性质

  1. (x−ΠX(y))⊤(y−ΠX(y))≤0(x - \Pi_X(y))^\top (y - \Pi_X(y)) \leq 0 for all x∈Xx \in X

  2. ∥x−ΠX(y)∥2+∥y−ΠX(y)∥2≤∥x−y∥2\|x - \Pi_X(y)\|^2 + \|y - \Pi_X(y)\|^2 \leq \|x - y\|^2 for all x∈Xx \in X

证明:
  1. 由于 ΠX(y)\Pi_X(y) 最小化 ∥x−y∥2\|x - y\|^2 over XX,由最优性条件,对任意 x∈Xx \in X,有:

    (ΠX(y)−y)⊤(x−ΠX(y))≥0(\Pi_X(y) - y)^\top (x - \Pi_X(y)) \geq 0

    即 (x−ΠX(y))⊤(y−ΠX(y))≤0(x - \Pi_X(y))^\top (y - \Pi_X(y)) \leq 0。

  2. 从1,有:

    ∥x−y∥2=∥x−ΠX(y)+ΠX(y)−y∥2=∥x−ΠX(y)∥2+∥ΠX(y)−y∥2+2(x−ΠX(y))⊤(ΠX(y)−y)\|x - y\|^2 = \|x - \Pi_X(y) + \Pi_X(y) - y\|^2 = \|x - \Pi_X(y)\|^2 + \|\Pi_X(y) - y\|^2 + 2 (x - \Pi_X(y))^\top (\Pi_X(y) - y)

    由于 (x−ΠX(y))⊤(ΠX(y)−y)≥0(x - \Pi_X(y))^\top (\Pi_X(y) - y) \geq 0,所以:

    ∥x−y∥2≥∥x−ΠX(y)∥2+∥ΠX(y)−y∥2\|x - y\|^2 \geq \|x - \Pi_X(y)\|^2 + \|\Pi_X(y) - y\|^2

    即性质2。

收敛速率

投影梯度下降的收敛速率与无约束情况相同,取决于函数性质:

  • 如果 ff 是凸且 LL-Lipschitz over XX,则误差 O(1/T)O(1/\sqrt{T}),迭代次数 O(1/ε2)O(1/\varepsilon^2)。

  • 如果 ff 是凸且 LL-平滑 over XX,则误差 O(1/T)O(1/T),迭代次数 O(1/ε)O(1/\varepsilon)。

  • 如果 ff 是 μ\mu-强凸且 LL-平滑 over XX,则误差 O(e−cT)O(e^{-c T}),迭代次数 O(log⁡(1/ε))O(\log(1/\varepsilon))。

证明草图:与无约束证明类似,但使用投影性质 bound ∥xt+1−x∗∥2\|x_{t+1} - x^*\|^2。例如,对于 Lipschitz 情况:
从更新:

yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t)

由投影性质2,有:

∥xt+1−x∗∥2≤∥yt+1−x∗∥2−∥yt+1−xt+1∥2≤∥yt+1−x∗∥2\|x_{t+1} - x^*\|^2 \leq \|y_{t+1} - x^*\|^2 - \|y_{t+1} - x_{t+1}\|^2 \leq \|y_{t+1} - x^*\|^2

然后与无约束类似分析。

总结表格

函数性质 算法 收敛速率 迭代次数
凸、LL-Lipschitz 梯度下降 f(xbest(T))−f(x∗)≤RLTf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{RL}{\sqrt{T}} O(1/ε2)O(1/\varepsilon^2)
凸、LL-平滑 梯度下降 f(xbest(T))−f(x∗)≤R2L2Tf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{R^2 L}{2T} O(1/ε)O(1/\varepsilon)
凸、LL-Lipschitz 次梯度法 f(xbest(T))−f(x∗)≤LRTf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{LR}{\sqrt{T}} O(1/ε2)O(1/\varepsilon^2)
μ\mu-强凸、LL-平滑 梯度下降 f(xbest(T))−f(x∗)≤RL2(1−μL)Tf(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{RL}{2}(1 - \frac{\mu}{L})^T O(log⁡(1/ε))O(\log(1/\varepsilon))
μ\mu-强凸、∣g∣≤B|g| \leq B 次梯度法 f(xbest(T))−f(x∗)≤2B2μ(T+1)f(x_{\text{best}}^{(T)}) - f(x^*) \leq \frac{2B^2}{\mu(T+1)} O(1/ε)O(1/\varepsilon)

其中 R=∥x0−x∗∥R = \|x_0 - x^*\|。

注意:实际应用中,步长选择对收敛至关重要。对于未知参数的情况,可能需要自适应步长策略。


补充说明

  1. 强凸与 Lipschitz 的冲突:
    非光滑函数不能同时是 Lipschitz 和强凸的(例如 f(x)=xf(x) = \sqrt{x} 在 x=0x=0 附近无界)。

  2. 次梯度范数与 Lipschitz 的关系:

    • Lipschitz 连续性 ⇒\Rightarrow 次梯度有界
    • 次梯度有界 ⇏\not\Rightarrow Lipschitz 连续
  3. 最优性:
    一阶方法(梯度/次梯度)的收敛速率在一般情况下是最优的,无法进一步改进。


⚙️