#sdsc6015

English / 中文

投影梯度下降 (Projected Gradient Descent)

投影梯度下降是处理约束优化问题的算法,通过梯度步后投影回可行集来确保约束满足。


约束优化问题定义

约束优化问题形式化定义为:

min⁡f(x)subject tox∈X\begin{aligned} &\min f(x) \\ &\text{subject to}\quad x \in X \end{aligned}

其中:

  • f:Rd→Rf: \mathbb{R}^d \rightarrow \mathbb{R} 是目标函数

  • X⊆RdX \subseteq \mathbb{R}^d 是一个闭凸集(closed convex set)

  • x∈Rdx \in \mathbb{R}^d 是优化变量

几何意义:在满足约束 x∈Xx \in X 的前提下,寻找使 f(x)f(x) 最小的点。


算法描述

投影梯度下降迭代步骤:

For t=0,1,2,… with stepsize ηt>0:yt+1=xt−ηt∇f(xt)xt+1=ΠX(yt+1)\begin{aligned} &\text{For } t = 0, 1, 2, \ldots \text{ with stepsize } \eta_t > 0: \\ &\quad y_{t+1} = x_t - \eta_t \nabla f(x_t) \\ &\quad x_{t+1} = \Pi_X(y_{t+1}) \end{aligned}

其中投影算子定义为:

ΠX(y):=arg min⁡x∈X∥x−y∥\Pi_X(y) := \operatorname*{arg\,min}_{x \in X} \|x - y\|

数学符号意义:

  • ηt\eta_t:步长参数,控制更新幅度

  • ∇f(xt)\nabla f(x_t):函数在 xtx_t 处的梯度

  • ΠX\Pi_X:投影算子,将点映射到 XX 中最近的点


收敛速率分析

收敛速率与无约束梯度下降相同,但每一步需要投影操作:

  • Lipschitz 凸函数(参数 GG):O(1/ε2)\mathcal{O}(1/\varepsilon^2) 步

  • 光滑凸函数(参数 LL):O(1/ε)\mathcal{O}(1/\varepsilon) 步

  • 光滑强凸函数(参数 μ,L\mu, L):O(log⁡(1/ε))\mathcal{O}(\log(1/\varepsilon)) 步

计算效率取决于投影操作的难易程度。


光滑函数上的收敛性

光滑性定义:函数 ff 在闭凸集 X⊆RdX \subseteq \mathbb{R}^d 上称为光滑(参数 LL),如果:

∥∇f(x)−∇f(y)∥≤L∥x−y∥,∀x,y∈X\|\nabla f(x) - \nabla f(y)\| \leq L\|x - y\|, \quad \forall x,y \in X

引理1(充分下降):

设 f:Rd→Rf: \mathbb{R}^d \rightarrow \mathbb{R} 可微且在闭凸集 X⊆RdX \subseteq \mathbb{R}^d 上光滑(参数 LL)。选择步长 η=1/L\eta = 1/L,投影梯度下降满足:

f(xt+1)≤f(xt)−12L∥∇f(xt)∥2+L2∥yt+1−xt+1∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L}\|\nabla f(x_t)\|^2 + \frac{L}{2}\|y_{t+1} - x_{t+1}\|^2

其中 yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t)。

引理1证明:

数学符号在投影中的意义

  • yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t):这是未投影的梯度步,即沿着梯度方向移动一步后的点,但可能不在可行集 XX 中。

  • xt+1=ΠX(yt+1)x_{t+1} = \Pi_X(y_{t+1}):这是投影后的点,通过投影算子 ΠX\Pi_X 将 yt+1y_{t+1} 映射到 XX 中最近的点,确保迭代点始终满足约束。

  • ∥yt+1−xt+1∥2\|y_{t+1} - x_{t+1}\|^2:这是投影误差,衡量未投影点与投影点之间的欧几里得距离平方。这个项在不等式中的作用是“惩罚”投影带来的偏差,因为投影操作可能使点偏离梯度方向。

  • ΠX(y):=arg min⁡x∈X∥x−y∥\Pi_X(y) := \operatorname*{arg\,min}_{x \in X} \|x - y\|:投影算子,表示将点 yy 投影到闭凸集 XX 上,找到 XX 中离 yy 最近的点。


证明

引理1的证明依赖于三个关键要素:函数的光滑性、投影的最优性条件、以及投影算子的几何性质(Fact(ii))。以下是证明步骤的详细解释:

  1. 利用函数光滑性:由于 ff 是 LL-光滑的,根据光滑性定义,对于任意点 xx 和 yy,有:

    f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥y−x∥2f(y) \leq f(x) + \nabla f(x)^\top (y - x) + \frac{L}{2} \|y - x\|^2

    应用此性质于 x=xtx = x_t 和 y=yt+1y = y_{t+1},并代入 yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t) 和 η=1/L\eta = 1/L,得到:

    f(yt+1)≤f(xt)−12L∥∇f(xt)∥2f(y_{t+1}) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2

    这一步给出了未投影点 yt+1y_{t+1} 的函数值上界。

  2. 投影的最优性条件:由于 xt+1=ΠX(yt+1)x_{t+1} = \Pi_X(y_{t+1}) 是投影点,对于闭凸集 XX,投影算子满足以下最优性条件:对于任意 x∈Xx \in X,有:

    (x−xt+1)⊤(yt+1−xt+1)≤0(x - x_{t+1})^\top (y_{t+1} - x_{t+1}) \leq 0

    特别地,取 x=xtx = x_t(因为 xt∈Xx_t \in X),有:

    (xt−xt+1)⊤(yt+1−xt+1)≤0(x_t - x_{t+1})^\top (y_{t+1} - x_{t+1}) \leq 0

    代入 yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t),经过代数变换,可得:

    ∇f(xt)⊤(xt+1−xt)≤−1η∥xt−xt+1∥2\nabla f(x_t)^\top (x_{t+1} - x_t) \leq -\frac{1}{\eta} \|x_t - x_{t+1}\|^2

    这个不等式将梯度内积与投影后的移动距离关联起来。

  3. 应用光滑性于 xt+1x_{t+1}:再次利用光滑性定义,这次应用于 x=xtx = x_t 和 y=xt+1y = x_{t+1}:

    f(xt+1)≤f(xt)+∇f(xt)⊤(xt+1−xt)+L2∥xt+1−xt∥2f(x_{t+1}) \leq f(x_t) + \nabla f(x_t)^\top (x_{t+1} - x_t) + \frac{L}{2} \|x_{t+1} - x_t\|^2

    将步骤2中的不等式代入,得到:

    f(xt+1)≤f(xt)−1η∥xt−xt+1∥2+L2∥xt+1−xt∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{\eta} \|x_t - x_{t+1}\|^2 + \frac{L}{2} \|x_{t+1} - x_t\|^2

    代入 η=1/L\eta = 1/L,简化得:

    f(xt+1)≤f(xt)−L2∥xt−xt+1∥2f(x_{t+1}) \leq f(x_t) - \frac{L}{2} \|x_t - x_{t+1}\|^2

  4. 利用投影性质(Fact(ii)):附件2中提到的 Fact(ii) 是投影算子的一个几何性质:对于任意 x∈Xx \in X 和 y∈Rdy \in \mathbb{R}^d,有:

    ∥x−ΠX(y)∥2+∥y−ΠX(y)∥2≤∥x−y∥2\|x - \Pi_X(y)\|^2 + \|y - \Pi_X(y)\|^2 \leq \|x - y\|^2

    取 x=xtx = x_t 和 y=yt+1y = y_{t+1},且 ΠX(yt+1)=xt+1\Pi_X(y_{t+1}) = x_{t+1},得到:

    ∥xt−xt+1∥2+∥yt+1−xt+1∥2\|x_t - x_{t+1}\|^2 + \|y_{t+1} - x_{t+1}\|^2


定理1:

设 f:Rd→Rf: \mathbb{R}^d \rightarrow \mathbb{R} 是一个凸且可微的函数。令 X⊆RdX \subseteq \mathbb{R}^d 是一个闭凸集,并假设存在一个最小化器 x∗∈Xx^* \in X 使得 f(x∗)=min⁡x∈Xf(x)f(x^*) = \min_{x \in X} f(x)。进一步,假设 ff 在 XX 上是光滑的(即梯度是 L-利普希茨连续),参数为 LL。选择步长 η=1L\eta = \frac{1}{L},则投影梯度下降算法产生的迭代序列满足以下收敛界:

f(xT)−f(x∗)≤L2T∥x0−x∗∥2f(x_T) - f(x^*) \leq \frac{L}{2T} \|x_0 - x^*\|^2

其中 xTx_T 是第 TT 次迭代后的点,x0x_0 是初始点。

定理1证明:

符号解释 (Notation Explanation)

  • ff:目标函数,从 Rd\mathbb{R}^d 映射到 R\mathbb{R},凸且可微。

  • XX:可行域,一个闭凸集(例如,约束条件定义的区域)。

  • x∗x^*:ff 在 XX 上的全局最小点,即 x∗=arg⁡min⁡x∈Xf(x)x^* = \arg\min_{x \in X} f(x)。

  • LL:光滑常数(Lipschitz 常数),表示梯度的变化上界,即 ∥∇f(x)−∇f(y)∥≤L∥x−y∥\|\nabla f(x) - \nabla f(y)\| \leq L \|x - y\| 对所有 x,y∈Xx, y \in X 成立。

  • η\eta:步长,在定理中设为 η=1L\eta = \frac{1}{L} 以确保收敛。

  • gtg_t:在点 xtx_t 处的梯度,即 gt=∇f(xt)g_t = \nabla f(x_t)。

  • xtx_t:第 tt 次迭代后的点(投影后)。

  • yt+1y_{t+1}:未投影的梯度步,计算为 yt+1=xt−ηgty_{t+1} = x_t - \eta g_t。

  • xt+1x_{t+1}:投影后的点,即 xt+1=ΠX(yt+1)x_{t+1} = \Pi_X(y_{t+1}),其中 ΠX\Pi_X 是到集合 XX 的投影算子。

投影算子 ΠX(y)\Pi_X(y) 返回 XX 中离 yy 最近的点,即 ΠX(y)=arg⁡min⁡x∈X∥x−y∥\Pi_X(y) = \arg\min_{x \in X} \|x - y\|。由于 XX 是闭凸集,投影存在且唯一。

证明概述 (Proof Sketch)

证明的核心在于利用函数的光滑性和凸性,以及投影算子的性质,来推导每次迭代的误差界。以下是关键步骤:

  1. 充分下降条件 (Sufficient Decrease)
    由于 ff 是 L-光滑的,对于投影梯度下降,有以下的充分下降不等式:

    f(xt+1)≤f(xt)−12L∥gt∥2+L2∥yt+1−xt+1∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L} \|g_t\|^2 + \frac{L}{2} \|y_{t+1} - x_{t+1}\|^2

    这个不等式表明,每次迭代后函数值下降的量受梯度大小和投影误差的影响。额外项 L2∥yt+1−xt+1∥2\frac{L}{2} \|y_{t+1} - x_{t+1}\|^2 是由于投影操作引入的。

  2. 投影算子的性质 (Projection Property)
    使用投影算子的一个关键事实(Fact ii):对于任意 x∈Xx \in X 和 y∈Rdy \in \mathbb{R}^d,有

    ∥x−ΠX(y)∥2+∥y−ΠX(y)∥2≤∥x−y∥2\|x - \Pi_X(y)\|^2 + \|y - \Pi_X(y)\|^2 \leq \|x - y\|^2

    令 x=x∗x = x^*(最优解)和 y=yt+1y = y_{t+1},由于 ΠX(yt+1)=xt+1\Pi_X(y_{t+1}) = x_{t+1},我们得到:

    ∥x∗−xt+1∥2+∥yt+1−xt+1∥2≤∥x∗−yt+1∥2\|x^* - x_{t+1}\|^2 + \|y_{t+1} - x_{t+1}\|^2 \leq \|x^* - y_{t+1}\|^2

    这个不等式反映了投影的“正交性”,即投影点与原始点的距离关系。

  3. 结合凸性 (Combining with Convexity)
    由 ff 的凸性,有:

    f(xt)−f(x∗)≤gt⊤(xt−x∗)f(x_t) - f(x^*) \leq g_t^\top (x_t - x^*)

    这表示函数值差被梯度与点差的内积所控制。

  4. 代数操作与抵消 (Algebraic Manipulation and Cancellation)
    将上述元素结合。首先,从普通梯度下降的分析框架出发,但用 yt+1y_{t+1} 替代 xt+1x_{t+1}(因为 yt+1y_{t+1} 是未投影的步骤)。然后,利用投影性质不等式和充分下降条件,通过代数操作发现额外项 ∥yt+1−xt+1∥2\|y_{t+1} - x_{t+1}\|^2 在求和时抵消。具体地,当步长 η=1L\eta = \frac{1}{L} 时,有:

    ∑t=0T−1(f(xt)−f(x∗))≤L2∥x0−x∗∥2\sum_{t=0}^{T-1} (f(x_t) - f(x^*)) \leq \frac{L}{2} \|x_0 - x^*\|^2

    由于 f(xt)f(x_t) 是递减的(由充分下降保证),最终得到 f(xT)−f(x∗)≤L2T∥x0−x∗∥2f(x_T) - f(x^*) \leq \frac{L}{2T} \|x_0 - x^*\|^2.

证明中的关键洞察是:投影操作虽然引入了误差项,但通过投影算子的性质,这些误差在整体分析中相互抵消,从而保持了与无约束梯度下降相同的收敛速率。

几何意义 (Geometric Interpretation)

  • 投影的作用:投影梯度下降通过将梯度步 yt+1y_{t+1} 投影回可行集 XX 来确保迭代点始终满足约束。投影操作可以看作是将点“拉回”到可行域上最近的点。

  • 收敛行为:由于函数光滑且凸,梯度方向指向下降方向,但投影可能改变路径。定理表明,即使有投影,收敛速率仍为 O(1/T)O(1/T),与无约束情况相同。这是因为投影误差在长期迭代中平均化,不影响整体趋势。

  • 直观理解:想象一个球在光滑凸面上滚动,每次沿梯度方向移动,但被约束在可行区域内。投影确保球不离开区域,而光滑性保证移动不会过度振荡,最终稳定到最低点。

例子 (Example)

虽然文档中没有提供具体例子,但一个典型应用是带约束的线性回归:目标函数 f(x)=∥Ax−b∥2f(x) = \|Ax - b\|^2 是光滑凸的,约束集 XX 可能是非负象限(x≥0x \geq 0)。投影梯度下降通过迭代更新 xx 并投影到 XX 上,确保解满足非负性,同时以 O(1/T)O(1/T) 速率收敛。

附注 (Additional Notes)

  • 定理假设了函数的光滑性和凸性,在实际中需验证这些条件。

  • 步长 η=1/L\eta = 1/L 是理论上的最优选择,但实践中可能使用自适应步长。

  • 收敛率 O(1/T)O(1/T) 是次线性的,对于大规模问题可能较慢,但这是凸优化中的标准结果。


强凸光滑函数上的收敛性

强凸函数定义:函数 ff 在集合 XX 上是强凸的(参数为 μ>0\mu > 0),如果对于所有 x,y∈Xx, y \in X,满足:

f(y)≥f(x)+∇f(x)⊤(y−x)+μ2∥y−x∥2f(y) \geq f(x) + \nabla f(x)^\top (y - x) + \frac{\mu}{2} \|y - x\|^2

这意味着函数具有一个下界二次项,确保其曲率有下界,从而加速优化收敛。

强凸函数的性质

  • 引理 2:强凸函数在 XX 上有唯一的最小化器 x∗x^{*}。

    这是由于强凸性避免了多个局部最小值,保证全局唯一解。

引理2证明:

数学符号与意义

  • ff: 定义在集合 X⊂RdX \subset \mathbb{R}^d 上的函数

  • μ>0\mu > 0: 强凸性参数

  • x∗x^{*}: 函数 ff 在 XX 上的最小化器

定理陈述

如果函数 ff 在集合 XX 上是 μ\mu-强凸的,那么 ff 在 XX 上存在唯一的最小化器 x∗x^{*}。

证明

  1. 存在性:由于 ff 是强凸函数,它也是凸函数,且 XX 是闭凸集,因此最小值存在。

  2. 唯一性(反证法):

    • 假设存在两个不同的最小化器 x1∗x_1^* 和 x2∗x_2^*,且 f(x1∗)=f(x2∗)=f∗f(x_1^*) = f(x_2^*) = f^*
    • 考虑中点 xm=x1∗+x2∗2x_m = \frac{x_1^* + x_2^*}{2}
    • 由强凸性定义:

      f(xm)≤12f(x1∗)+12f(x2∗)−μ8∥x1∗−x2∗∥2f(x_m) \leq \frac{1}{2}f(x_1^*) + \frac{1}{2}f(x_2^*) - \frac{\mu}{8}\|x_1^* - x_2^*\|^2

      f(xm)≤f∗−μ8∥x1∗−x2∗∥2<f∗f(x_m) \leq f^* - \frac{\mu}{8}\|x_1^* - x_2^*\|^2 < f^*

    • 这与 f∗f^* 是最小值的假设矛盾
    • 因此最小化器必须唯一

几何意义

强凸函数具有"陡峭的碗状"结构,确保函数只有一个全局最小值点,没有任何平坦区域或多个局部最小值。μ\mu 值越大,函数的"碗"形状越陡峭,优化过程更容易找到唯一解。

投影梯度下降的收敛性(Theorem 2)

  • 定理陈述:设 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 是凸可微函数,X⊂RdX \subset \mathbb{R}^d 是非空闭凸集。假设 ff 在 XX 上是平滑的(参数为 LL)且强凸的(参数为 μ>0\mu > 0)。选择步长 η=1/L\eta = 1/L,则任意初始点 x0x_0 的投影梯度下降满足:

    • (i) 到 x∗x^{*} 的平方距离几何递减:

      ∥xt+1−x∗∥2≤(1−μL)∥xt−x∗∥2\|x_{t+1} - x^{*}\|^2 \leq \left(1 - \frac{\mu}{L}\right) \|x_t - x^{*}\|^2

      这表示每次迭代后,解与最优解的距离以线性速率收缩。

    • (ii) 绝对误差随迭代指数减小:经过 TT 次迭代后,误差满足:

      f(xT)−f(x∗)≤L2(1−μL)T∥x0−x∗∥2f(x_T) - f(x^{*}) \leq \frac{L}{2} \left(1 - \frac{\mu}{L}\right)^T \|x_0 - x^{*}\|^2

      误差以指数速度下降,收敛速率取决于条件数 L/μL/\mu。

定理证明:

数学符号与意义

  • LL: 平滑性参数(Lipschitz常数)

  • η=1/L\eta = 1/L: 最优步长选择

  • xtx_t: 第 tt 次迭代后的解

  • yt+1=xt−η∇f(xt)y_{t+1} = x_t - \eta \nabla f(x_t): 未投影的梯度步

  • xt+1=ΠX(yt+1)x_{t+1} = \Pi_X(y_{t+1}): 投影后的解

定理陈述

对于 μ\mu-强凸且 LL-平滑的函数 ff,采用步长 η=1/L\eta = 1/L 的投影梯度下降满足:

(i) 平方距离几何递减:

∥xt+1−x∗∥2≤(1−μL)∥xt−x∗∥2\|x_{t+1} - x^{*}\|^2 \leq \left(1 - \frac{\mu}{L}\right) \|x_t - x^{*}\|^2

(ii) 函数值误差指数收敛:

f(xT)−f(x∗)≤L2(1−μL)T∥x0−x∗∥2f(x_T) - f(x^{*}) \leq \frac{L}{2} \left(1 - \frac{\mu}{L}\right)^T \|x_0 - x^{*}\|^2

证明概要

关键步骤:

  1. 梯度不等式:

    ∇f(xt)⊤(xt−x∗)≥f(xt)−f(x∗)+μ2∥xt−x∗∥2\nabla f(x_t)^\top (x_t - x^{*}) \geq f(x_t) - f(x^{*}) + \frac{\mu}{2} \|x_t - x^{*}\|^2

  2. 投影性质(附件2 P8):

    f(xt+1)≤f(xt)−12L∥∇f(xt)∥2+L2∥yt+1−xt+1∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2 + \frac{L}{2} \|y_{t+1} - x_{t+1}\|^2

  3. 距离递归关系:

    • 结合投影算子的非扩张性:∥ΠX(y)−ΠX(z)∥≤∥y−z∥\|\Pi_X(y) - \Pi_X(z)\| \leq \|y - z\|
    • 利用平滑性:f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥y−x∥2f(y) \leq f(x) + \nabla f(x)^\top (y - x) + \frac{L}{2} \|y - x\|^2
  4. 最终推导:

    ∥xt+1−x∗∥2≤∥yt+1−x∗∥2−∥yt+1−xt+1∥2=∥xt−η∇f(xt)−x∗∥2−∥yt+1−xt+1∥2≤(1−μL)∥xt−x∗∥2\begin{aligned} \|x_{t+1} - x^{*}\|^2 &\leq \|y_{t+1} - x^{*}\|^2 - \|y_{t+1} - x_{t+1}\|^2 \\ &= \|x_t - \eta \nabla f(x_t) - x^{*}\|^2 - \|y_{t+1} - x_{t+1}\|^2 \\ &\leq \left(1 - \frac{\mu}{L}\right) \|x_t - x^{*}\|^2 \end{aligned}

几何意义与解释

条件数 κ=L/μ\kappa = L/\mu:该定理揭示了收敛速率取决于函数的光滑性 (LL) 与强凸性 (μ\mu) 的比值。条件数越小(即函数越强凸或越平滑),收敛越快。

几何解释:

  • 强凸性确保函数有明确的"下降方向"
  • 平滑性确保梯度变化不会太剧烈,允许使用较大步长
  • 投影操作确保解始终保持在可行域 XX 内
  • 每次迭代都会将当前解指数级地拉向唯一最优解

实际意义:该定理保证了在合理条件下,投影梯度下降能够快速收敛到最优解,且误差随迭代次数指数下降。步长 η=1/L\eta = 1/L 是最优选择,平衡了收敛速度和稳定性。


投影步的计算例子

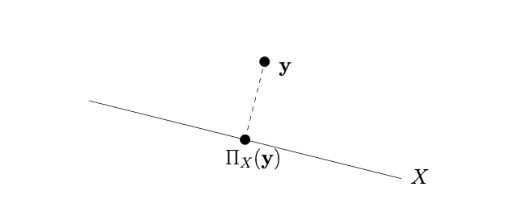
  • 投影操作 ΠX(y)=arg⁡min⁡x∈X∥x−y∥\Pi_X(y) = \arg\min_{x \in X} \|x - y\| 本身是一个优化问题,但在某些情况下可高效计算:

    • 投影到仿射子空间:通过求解线性方程组(类似最小二乘)实现。

      截屏2025-10-14 22.41.22.png

      例如,如果 XX 是超平面,投影有解析解。

    • 投影到欧几里得球(中心为 cc):通过缩放向量 y−cy - c 实现。

      ΠX(y)=c+R∥y−c∥(y−c)if∥y−c∥>R\Pi_X(y) = c + \frac{R}{\|y - c\|} (y - c) \quad \text{if} \quad \|y - c\| > R

      截屏2025-10-14 22.42.28.png

      其中 RR 是球半径,否则点已在球内。

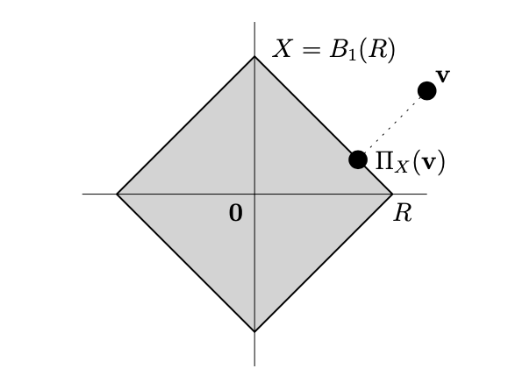
    • 投影到 ℓ1\ell_1-球(用于Lasso问题):可简化为投影到单纯形。

      • 设 B1(R)={x:∥x∥1≤R}B_1(R) = \{x : \|x\|_1 \leq R\},投影问题可转化为:

        min⁡x∈△d∥x−z∥2其中△d={x:∑ixi=1,xi≥0}\min_{x \in \triangle_d} \|x - z\|^2 \quad \text{其中} \quad \triangle_d = \{x : \sum_i x_i = 1, x_i \geq 0\}

        截屏2025-10-14 22.43.14.png

      投影到单纯形可在 O(dlog⁡d)\mathcal{O}(d \log d) 或 O(d)\mathcal{O}(d) 时间内计算(DSSSC08算法)。


近端梯度下降法 (Proximal Gradient Descent)

问题设定

考虑复合优化问题,目标函数由两部分组成:

f(x):=g(x)+h(x)f(x) := g(x) + h(x)

数学符号意义:

  • g(x)g(x): "性质良好"的函数(通常凸且LL-光滑)

  • h(x)h(x): "简单"但可能非光滑的附加项(如ℓ1\ell_1范数、指示函数等)

  • f(x)f(x): 待优化的复合目标函数

近端梯度下降法适用于求解非光滑、带约束或具有特殊结构的优化问题。

算法思想与更新公式

核心思想:将梯度下降思想推广到复合函数。对于光滑函数g(x)g(x),梯度下降步等价于最小化局部二次近似:

xt+1=arg⁡min⁡z{g(xt)+∇g(xt)⊤(z−xt)+12η∥z−xt∥2}x_{t+1} = \arg\min_z \left\{ g(x_t) + \nabla g(x_t)^\top (z - x_t) + \frac{1}{2\eta} \|z - x_t\|^2 \right\}

对于f=g+hf = g + h,保留对gg的二次近似,直接加上hh:

xt+1=arg⁡min⁡z{g(xt)+∇g(xt)⊤(z−xt)+12η∥z−xt∥2+h(z)}x_{t+1} = \arg\min_z \left\{ g(x_t) + \nabla g(x_t)^\top (z - x_t) + \frac{1}{2\eta} \|z - x_t\|^2 + h(z) \right\}

算法迭代公式:

xt+1=proxh,η(xt−η∇g(xt))x_{t+1} = \text{prox}_{h, \eta}(x_t - \eta \nabla g(x_t))

近端映射定义:

proxh,η(z)=arg⁡min⁡x{12η∥x−z∥2+h(x)}\text{prox}_{h, \eta}(z) = \arg\min_x \left\{ \frac{1}{2\eta} \|x - z\|^2 + h(x) \right\}

等价形式:

xt+1=xt−ηGh,η(xt)x_{t+1} = x_t - \eta G_{h,\eta}(x_t)

其中Gh,η(x)=1η(x−proxh,η(x−η∇g(x)))G_{h,\eta}(x) = \frac{1}{\eta}(x - \text{prox}_{h, \eta}(x - \eta \nabla g(x)))为广义梯度

特例与几何意义

h=0h = 0:退化为标准梯度下降

prox0,η(z)=z\text{prox}_{0, \eta}(z) = z

h=1Xh = 1_X(指示函数):退化为投影梯度下降

  • 指示函数:1X(x)={0,x∈X∞,x∉X1_X(x) = \begin{cases} 0, & x \in X \\ \infty, & x \notin X \end{cases}

  • 近端映射变为投影:prox1X,η(z)=πX(z)=arg⁡min⁡x∈X∥x−z∥\text{prox}_{1_X, \eta}(z) = \pi_X(z) = \arg\min_{x \in X} \|x - z\|

几何意义:近端映射在点zz附近寻找使h(x)h(x)较小的点,参数η\eta平衡"接近zz"和"使hh小"两个目标。

收敛性分析

定理3(近端梯度下降收敛性)

设g:Rd→Rg: \mathbb{R}^d \rightarrow \mathbb{R}凸且LL-光滑,hh凸,且可计算近端映射。选择步长η=1/L\eta = 1/L,则:

f(xT)−f(x∗)≤L2T∥x∗−x0∥2f(x_T) - f(x^*) \leq \frac{L}{2T} \|x^* - x_0\|^2

收敛速率为O(1/T)\mathcal{O}(1/T),与光滑凸函数上的梯度下降相同。

定理3证明思路:

数学符号意义

  • ψ(z)=g(xt)+∇g(xt)⊤(z−xt)+12η∥z−xt∥2+h(z)\psi(z) = g(x_t) + \nabla g(x_t)^\top (z - x_t) + \frac{1}{2\eta} \|z - x_t\|^2 + h(z):局部近似函数

  • xt+1=arg⁡min⁡zψ(z)x_{t+1} = \arg\min_z \psi(z):近端梯度步

  • ∥y−xt+1∥2\|y - x_{t+1}\|^2:近似误差项,衡量当前点与最优点的距离

证明步骤

  1. 定义局部近似函数:

    ψ(z)=g(xt)+∇g(xt)⊤(z−xt)+12η∥z−xt∥2+h(z)\psi(z) = g(x_t) + \nabla g(x_t)^\top (z - x_t) + \frac{1}{2\eta} \|z - x_t\|^2 + h(z)

    由于二次项存在,ψ(z)\psi(z)是强凸函数。

  2. 利用强凸性:根据xt+1x_{t+1}的定义和ψ\psi的强凸性:

    ψ(xt+1)≤ψ(y)−12η∥y−xt+1∥2,∀y\psi(x_{t+1}) \leq \psi(y) - \frac{1}{2\eta} \|y - x_{t+1}\|^2, \quad \forall y

  3. 转化为ff的递减性质:利用gg的LL-光滑性和凸性,将不等式转化为:

    f(xt+1)≤f(y)+12η∥y−xt∥2−12η∥y−xt+1∥2,∀yf(x_{t+1}) \leq f(y) + \frac{1}{2\eta} \|y - x_t\|^2 - \frac{1}{2\eta} \|y - x_{t+1}\|^2, \quad \forall y

  4. 求和与单调性:

    • 令y=x∗y = x^*,对t=0t = 0到T−1T-1求和
    • 利用函数值单调递减:f(xt+1)≤f(xt)f(x_{t+1}) \leq f(x_t)
    • 得到最终收敛界

几何直观:近端方法只"看到"光滑部分gg,非光滑部分hh被近端映射单独处理,不影响收敛速度。

实例:迭代软阈值算法 (ISTA)

Lasso回归问题:

min⁡β12∥y−Aβ∥22+λ∥β∥1\min_{\beta} \frac{1}{2} \|y - A\beta\|_2^2 + \lambda \|\beta\|_1

数学符号意义:

  • A∈Rn×dA \in \mathbb{R}^{n \times d}:特征矩阵

  • y∈Rny \in \mathbb{R}^n:响应变量

  • λ>0\lambda > 0:稀疏性调节参数

  • β∈Rd\beta \in \mathbb{R}^d:系数向量

分解:

  • g(β)=12∥y−Aβ∥22g(\beta) = \frac{1}{2} \|y - A\beta\|_2^2,∇g(β)=−A⊤(y−Aβ)\nabla g(\beta) = -A^\top (y - A\beta)

  • h(β)=λ∥β∥1h(\beta) = \lambda \|\beta\|_1

软阈值算子:

[proxh,η(z)]i=Sλ,η(zi)={zi−ηλif zi>ηλ0if ∣zi∣≤ηλzi+ηλif zi<−ηλ[\text{prox}_{h,\eta}(z)]_i = S_{\lambda,\eta}(z_i) = \begin{cases} z_i - \eta\lambda & \text{if } z_i > \eta\lambda \\ 0 & \text{if } |z_i| \leq \eta\lambda \\ z_i + \eta\lambda & \text{if } z_i < -\eta\lambda \end{cases}

ISTA迭代公式:

βt+1=Sλη(βt+ηA⊤(y−Aβt))\beta_{t+1} = S_{\lambda \eta}(\beta_t + \eta A^\top (y - A\beta_t))

推导说明:通过分析近端映射的一阶最优性条件,得到分段解析解,对应软阈值操作。


Mirror Descent


动机

考虑单纯形约束问题:

min⁡x∈△df(x)\min_{x \in \triangle_d} f(x)

其中 △d:={x∈Rd:∑i=1dxi=1,xi⩾0}\triangle_d := \{x \in \mathbb{R}^d : \sum_{i=1}^d x_i = 1, x_i \geqslant 0\}。假设梯度满足 ∥∇f(x)∥∞⩽1\|\nabla f(x)\|_\infty \leqslant 1,这意味着梯度的每个元素绝对值有界。

  • 收敛率比较:

    • 梯度下降(GD)在凸且L-Lipschitz函数上的收敛率为 O(dT)\mathcal{O}\left( \sqrt{\frac{d}{T}} \right)。
    • Mirror Descent 可以达到 O(log⁡dT)\mathcal{O}\left( \sqrt{\frac{\log d}{T}} \right),在高维问题(dd 大)中更优。
  • 为什么更优:GD的收敛率受维度 dd 影响,而Mirror Descent 通过镜像映射将依赖降低到 log⁡d\log d,更好地处理单纯形的几何。


数学符号意义
  • ∥⋅∥∞\|\cdot\|_\infty:无穷范数,表示向量中元素的最大绝对值,即 max⁡i∣xi∣\max_i |x_i|。

  • ∥⋅∥2\|\cdot\|_2:欧几里得范数,表示向量的标准长度,∥x∥2=∑ixi2\|x\|_2 = \sqrt{\sum_i x_i^2}。

  • LL:Lipschitz常数,这里由梯度范数导出,∥∇f(x)∥2⩽d=L\|\nabla f(x)\|_2 \leqslant \sqrt{d} = L。

  • dd:问题维度。

  • TT:迭代次数。

  • f(xbest)−f(x∗)f(x_{\text{best}}) - f(x^*):最优间隙,当前最佳解与最优解的函数值差。

  • ρ\rho:强凸系数,用于描述镜像势能 Φ\Phi 的凸性强度。

  • η\eta:步长,在Mirror Descent中设置为 η=2RLρT\eta = \frac{2R}{L} \sqrt{\frac{\rho}{T}}。

  • RR:定义域半径,R2=sup⁡x∈XDΦ(x,x1)R^2 = \sup_{x \in X} D_\Phi(x, x_1),其中 x1x_1 是初始点。

预备知识

  • 范数与对偶范数:固定范数 ∥⋅∥\|\cdot\|,对偶范数定义为 ∥g∥∗=sup⁡∥x∥≤1g⊤x\|g\|_* = \sup_{\|x\| \leq 1} g^\top x。

  • 函数性质:

    • LL-Lipschitz:∀x,g∈∂f(x),∥g∥∗⩽L\forall x, g \in \partial f(x), \|g\|_* \leqslant L。
    • β\beta-平滑:满足特定光滑条件。
    • μ\mu-强凸:f(y)≥f(x)+g⊤(y−x)+μ2∥y−x∥2f(y) \geq f(x) + g^\top (y-x) + \frac{\mu}{2} \|y-x\|^2。

Mirror Descent 迭代过程

Mirror Descent 的迭代分为两步:对偶更新和投影。这个过程确保在每次迭代中,点都保持在可行域 X 内。

  • 对偶更新步骤:

    yt+1=(∇Φ)−1(∇Φ(xt)−ηtgt)\boldsymbol{y}_{t+1} = (\nabla\Phi)^{-1}(\nabla\Phi(\boldsymbol{x}_{t}) - \eta_{t}\boldsymbol{g}_{t})

    其中:

    • xt\boldsymbol{x}_{t} 是当前迭代点(原始空间)。
    • ∇Φ\nabla\Phi 是 Mirror Potential 的梯度,用于映射到对偶空间。
    • ηt\eta_{t} 是步长(学习率)。
    • gt∈∂f(xt)\boldsymbol{g}_{t} \in \partial f(\boldsymbol{x}_{t}) 是目标函数 f 在 xt\boldsymbol{x}_{t} 处的次梯度(如果 f 可微,则为梯度)。这一步在对偶空间中执行梯度下降。
  • 投影步骤:

    xt+1=arg⁡min⁡x∈XDΦ(x,yt+1)\boldsymbol{x}_{t+1} = \underset{\boldsymbol{x} \in X}{\arg\min} D_{\Phi}(\boldsymbol{x}, \boldsymbol{y}_{t+1})

    其中 DΦD_{\Phi} 是 Bregman Divergence 关联到 Φ。这一步将中间点 yt+1\boldsymbol{y}_{t+1} 投影回可行域 X,最小化 Bregman Divergence。

几何解释
Mirror Descent 的几何意义可以从对偶空间和原始空间的角度理解:

  • 对偶空间:梯度步骤 ∇Φ(xt)−ηtgt\nabla\Phi(\boldsymbol{x}_{t}) - \eta_{t}\boldsymbol{g}_{t} 在对偶空间中执行,这是一个线性更新。
  • 原始空间:通过逆映射 (∇Φ)−1(\nabla\Phi)^{-1} 将对偶点映射回原始空间,然后通过 Bregman 投影确保可行性。
  • 示意图(如来自 Bubeck 2015)展示了这一过程:从对偶空间到原始空间的“镜像”映射,包括梯度步骤和投影,使算法在复杂几何下高效。
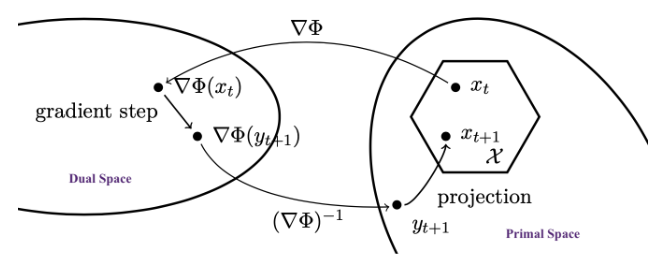
    截屏2025-10-15 00.27.22.png

关键要素

Mirror Potential(镜像势函数)

Mirror Potential 是 Mirror Descent 的核心函数,记作 Φ\Phi。它定义了从原始空间到对偶空间的映射。

  • 定义:Φ:Rd→R\Phi: \mathbb{R}^{d} \rightarrow \mathbb{R} 是一个函数,满足以下性质:

    • 严格凸性(Strictly Convex):确保优化问题有唯一解。
    • 连续可微性(Continuously Differentiable):梯度 ∇Φ\nabla \Phi 存在且连续,便于计算。
    • 极限条件:当 ∣∣x∣∣2→∞||x||_2 → \infty 时,∣∣∇Φ(x)∣∣→∞||\nabla \Phi(x)|| → \infty。这防止算法发散,保证稳定性。

Bregman Divergence(Bregman 散度)

Bregman Divergence 是一种非对称距离度量,用于替代欧几里得距离,基于一个凸函数(通常为 Φ\Phi 或相关函数 ff)。它定义了点之间的“差异”,并在投影步骤中用于确保可行性。

  • 定义:对于函数 ff,Bregman Divergence 定义为:

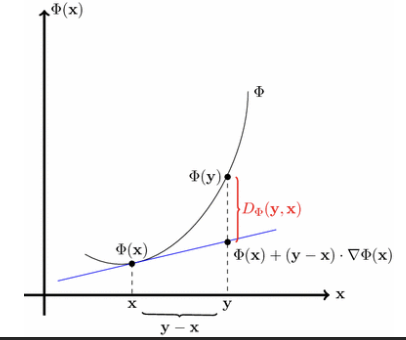
    Df(x,y)=f(x)−f(y)−∇f(y)⊤(x−y)D_f(x, y) = f(x) - f(y) - \nabla f(y)^\top (x - y)

    这衡量了 xx 和 yy 之间的凸性差异。

  • 性质:非负性(Df(x,y)≥0D_f(x, y) ≥ 0,且当 x=yx = y 时等号成立)、凸性在 xx 上。

截屏2025-10-15 00.33.14.png

投影算子

投影是 Mirror Descent 的关键部分,确保算法在约束集 X 上可行。

  • 投影定义:投影操作记为 ΠXΦ\Pi^{\Phi}_{X},使用 Bregman Divergence 关联到 Φ:

    ΠXΦ(y)=arg⁡min⁡x∈XDΦ(x,y)\Pi^{\Phi}_{X}(\boldsymbol{y}) = \arg\min_{\boldsymbol{x} \in X} D_{\Phi}(\boldsymbol{x}, \boldsymbol{y})

  • 存在性与唯一性:由于 Φ 的严格凸性和连续可微性,投影 ΠXΦ\Pi^{\Phi}_{X} 存在且唯一。这意味着对于任何点,都能找到唯一的投影点,避免算法的不确定性。

镜像下降法的收敛性

镜像下降法更新规则

镜像下降法(Mirror Descent)是一种优化算法,适用于非欧几里得空间中的凸优化问题。其更新规则如下:

  • 初始化:选择初始点 x1x_1,使得 x1∈arg min⁡x∈XΦ(x)x_1 \in \operatorname*{arg\,min}_{x \in X} \Phi(x),其中 Φ\Phi 是一个镜像映射(mirror map),XX 是可行域。

  • 对于每个时间步 t≥1t \geq 1:

    • 计算次梯度 gt∈∂f(xt)g_t \in \partial f(x_t),其中 ff 是目标函数。
    • 然后,定义 yt+1∈Rdy_{t+1} \in \mathbb{R}^d 满足:

      ∇Φ(yt+1)=∇Φ(xt)−ηgt\nabla\Phi(y_{t+1}) = \nabla\Phi(x_t) - \eta g_t

      其中 η\eta 是步长参数。

核心思想:在镜像空间(由 Φ\Phi 定义)中执行梯度下降,然后通过镜像映射投影回原始空间。∇Φ\nabla\Phi 是映射的梯度,它将点从原始空间映射到对偶空间。

定理4: 收敛性保证

假设:

  • Φ\Phi 是镜像映射,且在 XX 上关于范数 ∥⋅∥\|\cdot\| 是 ρ\rho-强凸的。

  • ff 是凸函数,且关于 ∥⋅∥\|\cdot\| 是 LL-Lipschitz 连续的。则 Mirror Descent 算法在步长 η=2RLρT\eta = \frac{2R}{L} \sqrt{\frac{\rho}{T}} 时满足:

f(1T∑t=1Txt)−f(x∗)≤2RLρTf(\frac{1}{T} \sum_{t=1}^T{x_t}) - f(x^*) \leq \frac{2RL}{\sqrt{\rho T}}

其中 RR 是初始点与最优解 x∗x^* 之间的“距离”上界,TT 是迭代次数。

符号意义:

  • ρ\rho:强凸性参数,衡量 Φ\Phi 的凸性强度。
  • LL:Lipschitz 常数,表示函数 ff 的变化率上界。
  • RR:通常定义为 R2=max⁡x∈XDΦ(x,x1)R^2 = \max_{x \in X} D_\Phi(x, x_1),反映问题规模。
  • η\eta:步长,控制更新幅度,依赖于问题参数以确保收敛。

标准设置示例

Ball Setup(球设置)

  • 镜像势能:Φ(x)=12∥x∥22\Phi(x) = \frac{1}{2} \|x\|_2^2

  • Bregman 散度:DΦ(x,y)=12∥x−y∥22D_\Phi(x, y) = \frac{1}{2} \|x - y\|_2^2

  • 此时,Mirror Descent 等价于投影次梯度下降(Projected Subgradient Descent),因为投影在欧几里得空间中进行。

Simplex Setup(单纯形设置)

  • 镜像势能:Φ(x)=∑i=1dxilog⁡xi\Phi(x) = \sum_{i=1}^d x_i \log x_i(负熵函数),定义在单纯形 △d={x∈Rd:xi≥0,∑ixi=1}\triangle_d = \{x \in \mathbb{R}^d : x_i \geq 0, \sum_i x_i = 1\} 上。

  • 梯度更新:∇Φ(yt+1)=∇Φ(xt)−η∇f(xt)\nabla \Phi(y_{t+1}) = \nabla \Phi(x_t) - \eta \nabla f(x_t) 可写为分量形式:

    yt+1,i=xt,iexp⁡(−η[∇f(xt)]i)y_{t+1,i} = x_{t,i} \exp(-\eta [\nabla f(x_t)]_i)

  • Bregman 散度:DΦ(x,y)=∑i=1dxilog⁡xiyiD_\Phi(x, y) = \sum_{i=1}^d x_i \log \frac{x_i}{y_i}(Kullback-Leibler 散度)。

  • 投影:在单纯形上的投影等价于重归一化 y→y/∥y∥1y \rightarrow y / \|y\|_1。

  • 例子:当 X=△dX = \triangle_d,初始点 x1=(1/d,…,1/d)x_1 = (1/d, \ldots, 1/d),则 R2=log⁡dR^2 = \log d,这适用于高维概率优化。

例子说明:Simplex setup 常用于机器学习中的概率模型优化,如在线学习或约束在概率单纯形上的问题。KL 散度的使用使得算法更适应概率分布的几何。

证明细节:
  1. 基础不等式:利用Bregman散度的性质,有:

    f(xt)−f(x)≤1η(DΦ(x,xt)−DΦ(x,xt+1))+η2ρ∥gt∥∗2f(x_t) - f(x) \leq \frac{1}{\eta} \left( D_\Phi(x, x_t) - D_\Phi(x, x_{t+1}) \right) + \frac{\eta}{2\rho} \|g_t\|_*^2

    • 来源:附件2 P47,通过一阶最优性条件和强凸性导出。
  2. 求和与 Telescoping:对 t=1t=1 到 TT 求和,DΦD_\Phi 项形成 telescoping 和:

    ∑t=1T[DΦ(x,xt)−DΦ(x,xt+1)]=DΦ(x,x1)−DΦ(x,xT+1)≤R2\sum_{t=1}^T [D_\Phi(x, x_t) - D_\Phi(x, x_{t+1})] = D_\Phi(x, x_1) - D_\Phi(x, x_{T+1}) \leq R^2

    • 因为 x1=arg⁡min⁡x∈XΦ(x)x_1 = \arg\min_{x \in X} \Phi(x),所以 DΦ(x,x1)≤R2D_\Phi(x, x_1) \leq R^2。
  3. 界住梯度项:由于 ff 是 LL-Lipschitz,∥gt∥∗≤L\|g_t\|_* \leq L,因此:

    ∑t=1Tη2ρ∥gt∥∗2≤ηTL22ρ\sum_{t=1}^T \frac{\eta}{2\rho} \|g_t\|_*^2 \leq \frac{\eta T L^2}{2\rho}

  4. 结合结果:

    ∑t=1T(f(xt)−f(x))≤R2η+ηTL22ρ\sum_{t=1}^T (f(x_t) - f(x)) \leq \frac{R^2}{\eta} + \frac{\eta T L^2}{2\rho}

    • 选择 η=2RLρT\eta = \frac{2R}{L} \sqrt{\frac{\rho}{T}} 最小化右端,得到收敛率。
  5. Jensen不等式:最后应用 Jensen 不等式于平均点 1T∑t=1Txt\frac{1}{T} \sum_{t=1}^T x_t。