#sdsc6015

English / 中文

回顾 - 凸函数与凸优化

点击展开

凸函数定义

回顾

函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 是凸函数当且仅当:

  1. 定义域 dom(f)\text{dom}(f) 是凸集;

  2. 对所有 x,y∈dom(f)\mathbf{x}, \mathbf{y} \in \text{dom}(f) 和 λ∈[0,1]\lambda \in [0,1],满足:

    f(λx+(1−λ)y)≤λf(x)+(1−λ)f(y)f(\lambda \mathbf{x} + (1-\lambda)\mathbf{y}) \leq \lambda f(\mathbf{x}) + (1-\lambda)f(\mathbf{y})

几何意义:函数图像上任意两点间的线段位于图像上方。


一阶凸性判定

回顾

若 ff 可微,则凸性等价于:

f(y)≥f(x)+∇f(x)⊤(y−x),∀x,y∈dom(f)f(\mathbf{y}) \geq f(\mathbf{x}) + \nabla f(\mathbf{x})^\top (\mathbf{y} - \mathbf{x}), \quad \forall \mathbf{x}, \mathbf{y} \in \text{dom}(f)

几何意义:函数图像始终在其切超平面的上方。


可微函数

回顾
  • 定义:ff 在 x0\mathbf{x}_0 可微当存在梯度 ∇f(x0)\nabla f(\mathbf{x}_0) 使得:

    f(x0+h)≈f(x0)+∇f(x0)⊤hf(\mathbf{x}_0 + \mathbf{h}) \approx f(\mathbf{x}_0) + \nabla f(\mathbf{x}_0)^\top \mathbf{h}

    其中 h\mathbf{h} 为微小扰动。

  • 全局可微:若在定义域内每点可微,则称 ff 可微,其图像在各点有非垂直切超平面。


凸优化问题

回顾

形式:

min⁡x∈Rdf(x)\min_{\mathbf{x} \in \mathbb{R}^d} f(\mathbf{x})

其中 ff 是凸可微函数,Rd\mathbb{R}^d 是凸集。全局最小值点记为 x∗=arg⁡min⁡f(x)\mathbf{x}^* = \arg\min f(\mathbf{x})(可能有多个)。


梯度下降法 (Gradient Descent)

核心思想

利用负梯度方向更新参数(梯度 ∇f(x)\nabla f(\mathbf{x}) 指向函数值增长最快的方向):

xk+1=xk−ηk∇f(xk)\mathbf{x}_{k+1} = \mathbf{x}_k - \eta_k \nabla f(\mathbf{x}_k)

其中:

  • xk\mathbf{x}_k:当前迭代点的参数向量(kk 为迭代次数)

  • ηk\eta_k:步长(学习率),控制更新幅度(ηk>0\eta_k > 0)

  • ∇f(xk)\nabla f(\mathbf{x}_k):函数 ff 在 xk\mathbf{x}_k 处的梯度

  • xk+1\mathbf{x}_{k+1}:更新后的参数向量

关键说明:

  1. 梯度方向:负梯度 −∇f(xk)-\nabla f(\mathbf{x}_k) 指向函数值下降最快的方向;
  2. 步长选择:
    • 固定步长(如 ηk=0.1\eta_k = 0.1)需满足收敛条件;
    • 自适应步长(如 ηk=1k\eta_k = \frac{1}{\sqrt{k}})可提升收敛性;
  3. 几何意义:每次迭代沿当前点的梯度方向线性移动 ηk∥∇f(xk)∥\eta_k \|\nabla f(\mathbf{x}_k)\| 的距离。

梯度下降示例:二次函数优化

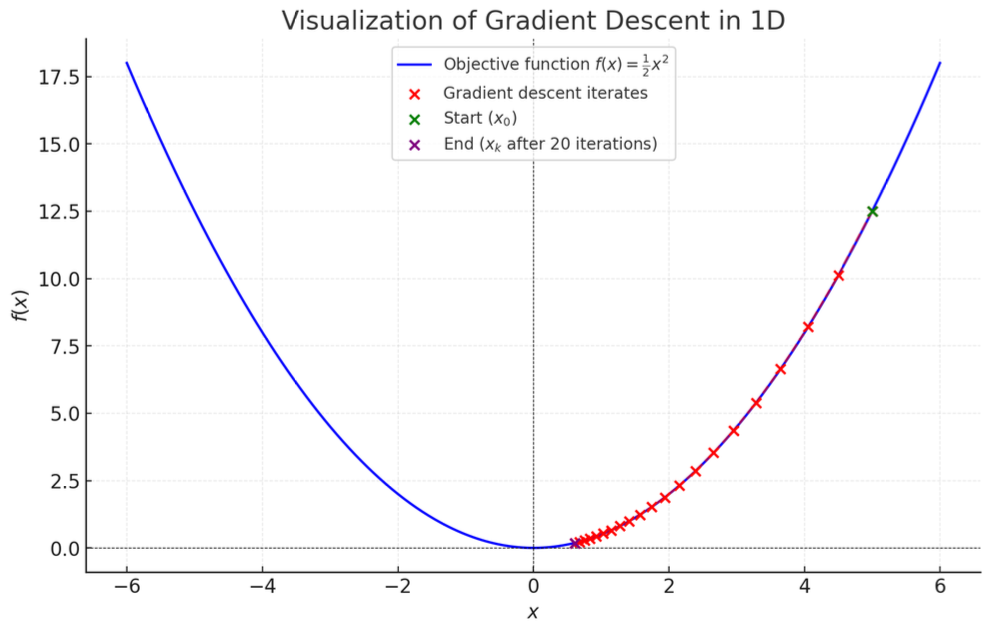
考虑凸函数 f(x)=12x2f(x) = \frac{1}{2} x^2:

  • 最小值点:x∗=0x^* = 0(函数在 x=0x=0 处取最小值 f(0)=0f(0)=0)

  • 梯度计算:

    ∇f(x)=ddx(12x2)=x\nabla f(x) = \frac{d}{dx} \left( \frac{1}{2} x^2 \right) = x

梯度下降更新规则

固定步长 η\eta 下的迭代公式:

xt+1=xt−η∇f(xt)=xt−ηxt=xt(1−η)x_{t+1} = x_t - \eta \nabla f(x_t) = x_t - \eta x_t = x_t (1 - \eta)

  • xtx_t:第 tt 次迭代的参数值

  • η\eta:步长(学习率),控制更新幅度

迭代序列通式

经过 kk 次迭代后:

xk=x0(1−η)kx_k = x_0 (1 - \eta)^k

推导说明:
由 xk=xk−1(1−η)x_{k} = x_{k-1} (1 - \eta) 递归展开:

xk=xk−1(1−η)=xk−2(1−η)2=⋯=x0(1−η)kx_k = x_{k-1} (1 - \eta) = x_{k-2} (1 - \eta)^2 = \cdots = x_0 (1 - \eta)^k

收敛性分析

当步长满足 0<η<10 < \eta < 1 时:

lim⁡k→∞xk=lim⁡k→∞x0(1−η)k=0\lim_{k \to \infty} x_k = \lim_{k \to \infty} x_0 (1 - \eta)^k = 0

解释:
由于 ∣1−η∣<1|1 - \eta| < 1,序列 (1−η)k(1 - \eta)^k 指数衰减到 0,因此迭代点收敛到最小值点 x∗=0x^* = 0。


具体参数下的收敛行为

  • 步长:η=0.1\eta = 0.1

  • 初始点:x0=5x_0 = 5

  • 迭代序列:

    xk=5×(0.9)kx_k = 5 \times (0.9)^k

  • 收敛过程:

    • k=0k=0: x0=5x_0 = 5
    • k=1k=1: x1=5×0.9=4.5x_1 = 5 \times 0.9 = 4.5
    • k=10k=10: x10=5×(0.9)10≈1.74x_{10} = 5 \times (0.9)^{10} \approx 1.74
    • k=50k=50: x50=5×(0.9)50≈0.034x_{50} = 5 \times (0.9)^{50} \approx 0.034(接近最小值点)

截屏2025-09-17 11.11.58.png

结论:
该示例验证了梯度下降在凸函数上的全局收敛性。步长 η=0.1\eta=0.1 满足 0<η<10<\eta<1,确保参数序列单调收敛到最优解 x∗=0x^*=0。


梯度下降基础分析(Vanilla Analysis)

目标:估计误差上界 f(xt)−f(x∗)f(\mathbf{x}_t) - f(\mathbf{x}^*)

定义梯度 gt:=∇f(xt)\mathbf{g}_t := \nabla f(\mathbf{x}_t),由梯度下降更新规则 xt+1=xt−ηgt\mathbf{x}_{t+1} = \mathbf{x}_t - \eta \mathbf{g}_t 可得:

gt=xt−xt+1η\mathbf{g}_t = \frac{\mathbf{x}_t - \mathbf{x}_{t+1}}{\eta}

关键等式推导

  1. 构造内积项:

    gt⊤(xt−x∗)=1η(xt−xt+1)⊤(xt−x∗)\mathbf{g}_t^\top (\mathbf{x}_t - \mathbf{x}^*) = \frac{1}{\eta} (\mathbf{x}_t - \mathbf{x}_{t+1})^\top (\mathbf{x}_t - \mathbf{x}^*)

  2. 应用向量恒等式(2v⊤w=∥v∥2+∥w∥2−∥v−w∥22\mathbf{v}^\top\mathbf{w} = \|\mathbf{v}\|^2 + \|\mathbf{w}\|^2 - \|\mathbf{v} - \mathbf{w}\|^2):

    gt⊤(xt−x∗)=12η(∥xt−xt+1∥2+∥xt−x∗∥2−∥xt+1−x∗∥2)=η2∥gt∥2+12η(∥xt−x∗∥2−∥xt+1−x∗∥2)\begin{aligned} \mathbf{g}_t^\top (\mathbf{x}_t - \mathbf{x}^*) &= \frac{1}{2\eta} \left( \|\mathbf{x}_t - \mathbf{x}_{t+1}\|^2 + \|\mathbf{x}_t - \mathbf{x}^*\|^2 - \|\mathbf{x}_{t+1} - \mathbf{x}^*\|^2 \right) \\ &= \frac{\eta}{2} \|\mathbf{g}_t\|^2 + \frac{1}{2\eta} \left( \|\mathbf{x}_t - \mathbf{x}^*\|^2 - \|\mathbf{x}_{t+1} - \mathbf{x}^*\|^2 \right) \end{aligned}

    说明:

    • 第一项 η2∥gt∥2\frac{\eta}{2} \|\mathbf{g}_t\|^2 控制梯度模长;
    • 第二项 12η(∥xt−x∗∥2−∥xt+1−x∗∥2)\frac{1}{2\eta} (\|\mathbf{x}_t - \mathbf{x}^*\|^2 - \|\mathbf{x}_{t+1} - \mathbf{x}^*\|^2) 表示参数空间距离变化。
  3. 对 TT 步求和:

    ∑t=0T−1gt⊤(xt−x∗)=η2∑t=0T−1∥gt∥2+12η(∥x0−x∗∥2−∥xT−x∗∥2)\sum_{t=0}^{T-1} \mathbf{g}_t^\top (\mathbf{x}_t - \mathbf{x}^*) = \frac{\eta}{2} \sum_{t=0}^{T-1} \|\mathbf{g}_t\|^2 + \frac{1}{2\eta} \left( \|\mathbf{x}_0 - \mathbf{x}^*\|^2 - \|\mathbf{x}_T - \mathbf{x}^*\|^2 \right)

结合凸函数一阶条件

由凸性:f(x∗)≥f(xt)+gt⊤(x∗−xt)f(\mathbf{x}^*) \geq f(\mathbf{x}_t) + \mathbf{g}_t^\top (\mathbf{x}^* - \mathbf{x}_t),可得单步误差上界:

f(xt)−f(x∗)≤gt⊤(xt−x∗)f(\mathbf{x}_t) - f(\mathbf{x}^*) \leq \mathbf{g}_t^\top (\mathbf{x}_t - \mathbf{x}^*)

代入求和式得累积误差界:

∑t=0T−1[f(xt)−f(x∗)]≤η2∑t=0T−1∥gt∥2+12η(∥x0−x∗∥2−∥xT−x∗∥2)\sum_{t=0}^{T-1} \left[ f(\mathbf{x}_t) - f(\mathbf{x}^*) \right] \leq \frac{\eta}{2} \sum_{t=0}^{T-1} \|\mathbf{g}_t\|^2 + \frac{1}{2\eta} \left( \|\mathbf{x}_0 - \mathbf{x}^*\|^2 - \|\mathbf{x}_T - \mathbf{x}^*\|^2 \right)

核心结论:

  1. 累积误差由梯度范数之和 ∑∥gt∥2\sum \|\mathbf{g}_t\|^2 和初始距离 ∥x0−x∗∥2\|\mathbf{x}_0 - \mathbf{x}^*\|^2 控制;
  2. 步长 η\eta 的平衡作用:
    • 过大:梯度项 η2∑∥gt∥2\frac{\eta}{2} \sum \|\mathbf{g}_t\|^2 主导,可能发散;
    • 过小:距离项 12η∥x0−x∗∥2\frac{1}{2\eta} \|\mathbf{x}_0 - \mathbf{x}^*\|^2 主导,收敛缓慢。

Lipschitz 凸函数的梯度下降收敛性分析

假设f的所有梯度的范数有界。

  • 等价于ff是 Lipschitz 的(见笔记)

  • 排除了许多有趣的函数(例如,f(x)=x2f(x) = x^2)

等价证明

设函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 为凸函数,以下两个性质等价:

  1. 梯度有界(Bounded Gradient):存在 M>0M > 0,使得 ∥∇f(x)∥≤M, ∀x\|\nabla f(x)\| \leq M, \ \forall x。

  2. Lipschitz 连续:存在 L>0L > 0,使得 ∥f(y)−f(x)∥≤L∥y−x∥, ∀x,y\|f(y) - f(x)\| \leq L \|y - x\|, \ \forall x, y。


证明过程整理

(⇒) 梯度有界 ⇒ Lipschitz 连续

假设 ∥∇f(x)∥≤M\|\nabla f(x)\| \leq M,由微积分基本定理:

f(y)−f(x)=∫01∇f(x+t(y−x))⊤(y−x) dtf(y) - f(x) = \int_0^1 \nabla f(x + t(y-x))^\top (y-x) \, dt

取范数并应用 Cauchy-Schwarz 不等式:

∥f(y)−f(x)∥≤∫01∥∇f(x+t(y−x))∥⋅∥y−x∥ dt\|f(y) - f(x)\| \leq \int_0^1 \|\nabla f(x + t(y-x))\| \cdot \|y - x\| \, dt

代入梯度有界条件:

∥f(y)−f(x)∥≤∫01M∥y−x∥ dt=M∥y−x∥\|f(y) - f(x)\| \leq \int_0^1 M \|y - x\| \, dt = M \|y - x\|

即 ff 是 MM-Lipschitz 连续。

解释:梯度范数有界保证了函数值变化率受控,从而函数整体变化受限于输入变化。


(⇐) Lipschitz 连续 ⇒ 梯度有界

假设 ∥f(y)−f(x)∥≤L∥y−x∥\|f(y) - f(x)\| \leq L \|y - x\|,且 ff 为凸函数。需证 ∥∇f(x)∥≤L\|\nabla f(x)\| \leq L。

  • 若∇f(x)=0\nabla f(x) = 0:结论显然成立。

  • 否则:取 y=x+∇f(x)y = x + \nabla f(x)。
    由凸函数的一阶条件:

    f(y)≥f(x)+∇f(x)⊤(y−x)f(y) \geq f(x) + \nabla f(x)^\top (y - x)

    代入 y−x=∇f(x)y - x = \nabla f(x):

    f(y)−f(x)≥∇f(x)⊤∇f(x)=∥∇f(x)∥2(∗)f(y) - f(x) \geq \nabla f(x)^\top \nabla f(x) = \|\nabla f(x)\|^2 \quad (*)

    由 Lipschitz 连续性:

    f(y)−f(x)≤L∥y−x∥=L∥∇f(x)∥(∗∗)f(y) - f(x) \leq L \|y - x\| = L \|\nabla f(x)\| \quad (**)

    结合 (∗)(*) 和 (∗∗)(**):

    ∥∇f(x)∥2≤L∥∇f(x)∥\|\nabla f(x)\|^2 \leq L \|\nabla f(x)\|

    即 ∥∇f(x)∥≤L\|\nabla f(x)\| \leq L。

解释:Lipschitz 连续性限制了函数值的线性增长,迫使梯度范数有界。凸函数的一阶条件将梯度范数与函数值变化关联,完成等价性闭环。


关键公式注释

  1. 微积分基本定理的应用:

    f(y)−f(x)=∫01∇f(x+t(y−x))⊤(y−x) dtf(y) - f(x) = \int_0^1 \nabla f(x + t(y-x))^\top (y-x) \, dt

    • 意义:将函数值差表示为梯度沿路径 x→yx \to y 的积分。
  2. Cauchy-Schwarz 不等式:

    ∣∇f(z)⊤(y−x)∣≤∥∇f(z)∥⋅∥y−x∥\left| \nabla f(z)^\top (y-x) \right| \leq \|\nabla f(z)\| \cdot \|y - x\|

    • 作用:将内积转化为范数乘积,便于控制积分上界。
  3. 凸函数一阶条件:

    f(y)≥f(x)+∇f(x)⊤(y−x)f(y) \geq f(x) + \nabla f(x)^\top (y - x)

    • 作用:建立梯度与函数值变化的单向关系(梯度指向函数值增长方向)。

附:P47 示例
对 f(x)=∣x∣f(x) = |x|:

  • 在 x>0x > 0 时,gk=1g_k = 1,梯度下降可能越过最优解 x∗=0x^* = 0。
  • 在 x=0x = 0 时,次梯度 gk∈[−1,1]g_k \in [-1, 1],导致振荡。
    说明非光滑函数需专门优化方法(如次梯度法)。

定理设定

设 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 为凸可微函数,且满足:

  1. ∥x0−x∗∥≤R\|\mathbf{x}_0 - \mathbf{x}^*\| \leq R(初始点与最优解距离有界)

  2. ∥∇f(x)∥≤B, ∀x\|\nabla f(\mathbf{x})\| \leq B,\ \forall \mathbf{x}(梯度模长有界,等价于 ff 是 BB-Lipschitz)

收敛证明

  1. 基础不等式(由 Vanilla Analysis):

    ∑t=0T−1[f(xt)−f(x∗)]≤η2∑t=0T−1∥gt∥2+12η∥x0−x∗∥2\sum_{t=0}^{T-1} [f(\mathbf{x}_t) - f(\mathbf{x}^*)] \leq \frac{\eta}{2} \sum_{t=0}^{T-1} \|\mathbf{g}_t\|^2 + \frac{1}{2\eta} \|\mathbf{x}_0 - \mathbf{x}^*\|^2

  2. 代入有界条件:

    ∑t=0T−1[f(xt)−f(x∗)]≤η2B2T+R22η\sum_{t=0}^{T-1} [f(\mathbf{x}_t) - f(\mathbf{x}^*)] \leq \frac{\eta}{2} B^2 T + \frac{R^2}{2\eta}

  3. 优化步长 η\eta:定义辅助函数:

    h(η)=ηB2T2+R22ηh(\eta) = \frac{\eta B^2 T}{2} + \frac{R^2}{2\eta}

    • 求导得最优步长:

      h′(η)=B2T2−R22η2=0 ⇒ η∗=RBTh'(\eta) = \frac{B^2 T}{2} - \frac{R^2}{2\eta^2} = 0 \ \Rightarrow \ \eta^* = \frac{R}{B\sqrt{T}}

    • 代入得最小上界:

      h(η∗)=RBT⋅B2T2+R22⋅RBT=RBTh(\eta^*) = \frac{R}{B\sqrt{T}} \cdot \frac{B^2 T}{2} + \frac{R^2}{2 \cdot \frac{R}{B\sqrt{T}}} = RB\sqrt{T}

  4. 平均误差界:

    1T∑t=0T−1[f(xt)−f(x∗)]≤RBT\frac{1}{T} \sum_{t=0}^{T-1} [f(\mathbf{x}_t) - f(\mathbf{x}^*)] \leq \frac{RB}{\sqrt{T}}

收敛速率与迭代次数

  • 达到精度 ε\varepsilon 所需迭代次数:

    T≥R2B2ε2⇒RBT≤εT \geq \frac{R^2 B^2}{\varepsilon^2} \quad \Rightarrow \quad \frac{RB}{\sqrt{T}} \leq \varepsilon

  • 优势:

    1. 维度无关性:收敛速率与问题维度 dd 无关
    2. 鲁棒性:对平均迭代值 1T∑f(xt)\frac{1}{T}\sum f(\mathbf{x}_t) 和最佳迭代值 min⁡tf(xt)\min_t f(\mathbf{x}_t) 均成立

注:Lipschitz 条件排除了梯度无界的函数(如 f(x)=x2f(x)=x^2),此类函数需用平滑性分析。

实践建议(RR, BB 未知时)

  1. 固定小步长:初始尝试 η=0.01\eta = 0.01

  2. 动态调整:

    • 若振荡/发散 → 减小 η\eta
    • 或采用衰减步长 ηt=η0t+1\eta_t = \frac{\eta_0}{\sqrt{t+1}}
  3. 自适应方法:使用 Adam 等自适应优化器


平滑函数 (Smooth Functions)

定义

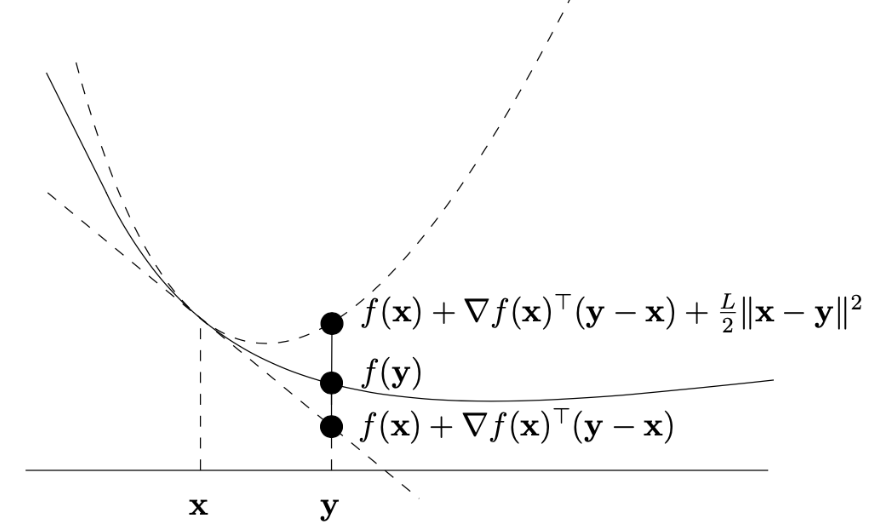
设函数 f:dom(f)→Rf : \text{dom}(f) \to \mathbb{R} 可微,定义域子集 X⊆dom(f)X \subseteq \text{dom}(f),参数 L>0L > 0。若对所有 x,y∈Xx, y \in X 满足:

f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥x−y∥2f(y) \leq f(x) + \nabla f(x)^\top (y - x) + \frac{L}{2} \|x - y\|^2

则称 ff 在 XX 上是平滑的(参数为 LL)。

直观理解:

  • 函数“弯曲程度不大”,其值增长不超过一个二次函数(类似抛物面)。
  • LL 量化了梯度变化的最大速率(梯度变化越快,LL 越大)。

几何意义

平滑性表明:在任意点 xx 附近,函数 ff 可被一个二次函数上界控制(如图形为抛物面)。

截屏2025-09-17 12.28.48.png

示例:
二次函数(如 f(x)=x2f(x) = x^2)是平滑的。


保持平滑性的运算

以下运算在指定条件下保持函数的平滑性:

引理 1
(i) 设 f1,…,fmf_1, \dots, f_m 是平滑函数,参数分别为 L1,…,LmL_1, \dots, L_m,权重 λ1,…,λm∈R+\lambda_1, \dots, \lambda_m \in \mathbb{R}^+。则线性组合 f:=∑i=1mλifif := \sum_{i=1}^m \lambda_i f_i 是平滑的,参数为 ∑i=1mλiLi\sum_{i=1}^m \lambda_i L_i。
(ii) 设 ff 是平滑函数(参数 LL),g:Rm→Rdg: \mathbb{R}^m \to \mathbb{R}^d 是仿射函数(即 g(x)=Ax+bg(x) = Ax + b,其中 A∈Rd×mA \in \mathbb{R}^{d \times m}, b∈Rdb \in \mathbb{R}^d)。则复合函数 f∘gf \circ g(映射 x↦f(Ax+b)x \mapsto f(Ax + b))是平滑的,参数为 L∥A∥2L \|A\|_2。

其中 ∥A∥2\|A\|_2 是矩阵 AA 的谱范数(即最大奇异值)。


凸函数 vs. 平滑函数:性质与优化特性

基本概念对比

性质 数学定义 几何意义 优化意义
凸性 f(λx+(1−λ)y)≤λf(x)+(1−λ)f(y)f(\lambda x + (1-\lambda)y) \leq \lambda f(x) + (1-\lambda)f(y) 函数图像始终在弦下方 保证全局最优性
Lipschitz连续性 ∣∇f(x)∣≤B|\nabla f(x)| \leq B 梯度有界,函数变化率受限 控制梯度下降的稳定性
平滑性 ∣∇f(x)−∇f(y)∣≤L∣x−y∣|\nabla f(x) - \nabla f(y)| \leq L|x-y| 梯度变化平缓,曲率有界 实现更快的收敛速率

关键等价关系

引理 2:平滑性的等价刻画

对于凸可微函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R},以下两个陈述等价:

  1. ff 是 LL-平滑的:f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥x−y∥2f(y) \leq f(x) + \nabla f(x)^\top(y-x) + \frac{L}{2}\|x-y\|^2

  2. 梯度是 LL-Lipschitz 连续的:∥∇f(x)−∇f(y)∥≤L∥x−y∥\|\nabla f(x) - \nabla f(y)\| \leq L\|x-y\|

重要性:这建立了函数平滑性与梯度Lipschitz连续性之间的等价关系,为分析优化算法提供了理论基础。

平滑函数的梯度下降分析

引理 3:充分下降性

对于 LL-平滑函数,采用步长 η=1L\eta = \frac{1}{L} 的梯度下降满足:

f(xt+1)≤f(xt)−12L∥∇f(xt)∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2

证明:

f(xt+1)≤f(xt)+∇f(xt)⊤(xt+1−xt)+L2∥xt+1−xt∥2=f(xt)−1L∥∇f(xt)∥2+12L∥∇f(xt)∥2=f(xt)−12L∥∇f(xt)∥2\begin{aligned} f(x_{t+1}) &\leq f(x_t) + \nabla f(x_t)^\top(x_{t+1}-x_t) + \frac{L}{2}\|x_{t+1}-x_t\|^2 \\ &= f(x_t) - \frac{1}{L} \|\nabla f(x_t)\|^2 + \frac{1}{2L} \|\nabla f(x_t)\|^2 \\ &= f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2 \end{aligned}

意义:每次迭代都保证函数值下降,且下降量由梯度范数控制。

定理 2:收敛速率

对于 LL-平滑凸函数,采用 η=1L\eta = \frac{1}{L} 的梯度下降满足:

f(xT)−f(x∗)≤L∥x0−x∗∥22Tf(x_T) - f(x^*) \leq \frac{L \|x_0 - x^*\|^2}{2T}

证明思路:

  1. 利用基础分析不等式

  2. 应用充分下降引理 bound 梯度项

  3. 通过 telescoping sum 得到最终界

实际应用与比较

收敛速率比较

函数类型 收敛速率 迭代复杂度 (ε\varepsilon-精度)
Lipschitz 凸函数 O(1/T)O(1/\sqrt{T}) O(1/ε2)O(1/\varepsilon^2)
平滑凸函数 O(1/T)O(1/T) O(1/ε)O(1/\varepsilon)

优势:平滑性使收敛速率从次线性提升到线性,显著提高优化效率。

实践建议:未知 LL 的情况

  1. 初始猜测:设 L=2εR2L = \frac{2\varepsilon}{R^2}(如正确,一次迭代可达精度)

  2. 验证条件:检查 f(xt+1)≤f(xt)−12L∥∇f(xt)∥2f(x_{t+1}) \leq f(x_t) - \frac{1}{2L} \|\nabla f(x_t)\|^2

  3. 加倍策略:如条件不满足,加倍 LL 并重试

  4. 总复杂度:最多 O(4R2Lε)O\left(\frac{4R^2L}{\varepsilon}\right) 次迭代可达精度 ε\varepsilon

实际意义:即使不知道平滑参数,也能通过自适应调整实现高效优化。


次梯度(Subgradient)

次梯度 (Subgradient) 定义

对于凸函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R},在点 x\mathbf{x} 的次梯度是任意满足以下条件的向量 g∈Rd\mathbf{g} \in \mathbb{R}^d:

f(y)≥f(x)+g⊤(y−x),∀yf(\mathbf{y}) \geq f(\mathbf{x}) + \mathbf{g}^\top (\mathbf{y} - \mathbf{x}), \quad \forall \mathbf{y}

重要性质:

  • 在定义域内点,次梯度总是存在
  • 如果 ff 在 x\mathbf{x} 处可微,则次梯度唯一且等于梯度 ∇f(x)\nabla f(\mathbf{x})

次梯度计算示例

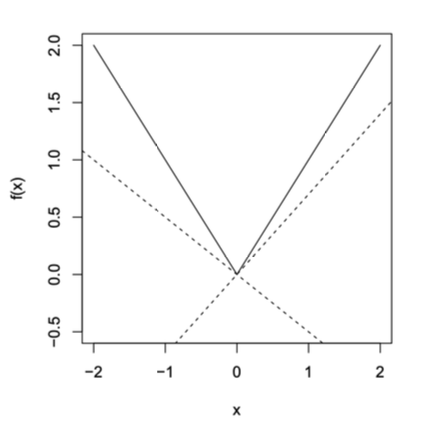
示例 1: 绝对值函数 f(x)=∣x∣f(x) = |x|

截屏2025-09-17 14.45.33.png

  • 当 x≠0x \neq 0: 唯一次梯度 g=sign(x)g = \text{sign}(x)

  • 当 x=0x = 0: 次梯度为 [−1,1][-1, 1] 区间内任意值

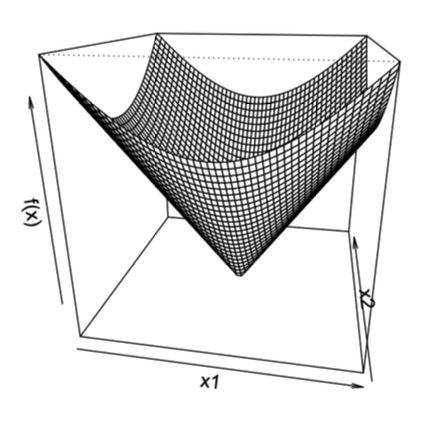
示例 2: L2 范数 f(x)=∥x∥2f(\mathbf{x}) = \|\mathbf{x}\|_2

截屏2025-09-17 14.45.54.png

  • 当 x≠0\mathbf{x} \neq \mathbf{0}: 唯一次梯度 g=x∥x∥2\mathbf{g} = \frac{\mathbf{x}}{\|\mathbf{x}\|_2}

  • 当 x=0\mathbf{x} = \mathbf{0}: 次梯度为闭单位球内任意向量 {z∈Rd:∥z∥2≤1}\{\mathbf{z} \in \mathbb{R}^d : \|\mathbf{z}\|_2 \leq 1\}

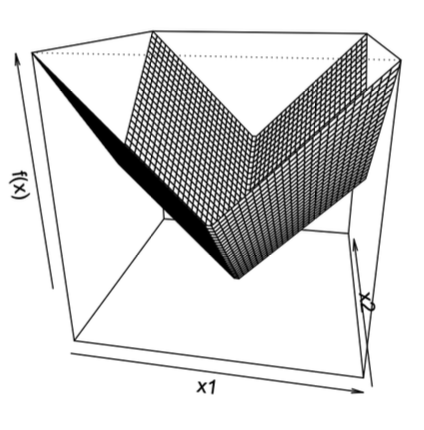
示例 3: L1 范数 f(x)=∥x∥1=∑i=1d∣xi∣f(\mathbf{x}) = \|\mathbf{x}\|_1 = \sum_{i=1}^d |x_i|

截屏2025-09-17 14.46.59.png

  • 当 xi≠0x_i \neq 0: 第 ii 个分量 gi=sign(xi)g_i = \text{sign}(x_i)

  • 当 xi=0x_i = 0: 第 ii 个分量 gig_i 为 [−1,1][-1, 1] 区间内任意值

示例 4: 集合示性函数 (Indicator Function)

对于凸集 X⊂RdX \subset \mathbb{R}^d,示性函数定义为:

1X(x)={0if x∈X+∞if x∉X1_X(\mathbf{x}) = \begin{cases} 0 & \text{if } \mathbf{x} \in X \\ +\infty & \text{if } \mathbf{x} \notin X \end{cases}

法锥 (Normal Cone)

定义:给定凸集 X⊆RdX \subseteq \mathbb{R}^d 和点 x∈X\mathbf{x} \in X,法锥是所有从 x\mathbf{x} 点向外指向的向量集合:

NX(x)={g∈Rd∣g⊤x≥g⊤y, ∀y∈X}\mathcal{N}_X(\mathbf{x}) = \{ \mathbf{g} \in \mathbb{R}^d \mid \mathbf{g}^\top \mathbf{x} \geq \mathbf{g}^\top \mathbf{y},\ \forall \mathbf{y} \in X \}

几何解释:法锥包含的是在点 x\mathbf{x} 处"支撑"凸集 XX 的所有超平面的法向量。这些向量指向集合外部,与集合在该点处的所有可能方向都成直角或钝角。

次微分 (Subdifferential)

定义:凸函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 在点 x\mathbf{x} 的次微分是所有次梯度组成的集合:

∂f(x)={g∈Rd∣f(y)≥f(x)+g⊤(y−x), ∀y∈Rd}\partial f(\mathbf{x}) = \{ \mathbf{g} \in \mathbb{R}^d \mid f(\mathbf{y}) \geq f(\mathbf{x}) + \mathbf{g}^\top (\mathbf{y} - \mathbf{x}),\ \forall \mathbf{y} \in \mathbb{R}^d \}

性质:

  • ∂f(x)\partial f(\mathbf{x}) 是闭凸集

  • 如果 ff 在 x\mathbf{x} 处可微,则 ∂f(x)={∇f(x)}\partial f(\mathbf{x}) = \{ \nabla f(\mathbf{x}) \}

  • 如果 ∂f(x)={g}\partial f(\mathbf{x}) = \{ \mathbf{g} \}(单点集),则 ff 在 x\mathbf{x} 处可微且 ∇f(x)=g\nabla f(\mathbf{x}) = \mathbf{g}

最优性条件

无约束优化

对于任意凸函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R}:

f(x∗)=min⁡xf(x)  ⟺  0∈∂f(x∗)f(\mathbf{x}^*) = \min_{\mathbf{x}} f(\mathbf{x}) \iff 0 \in \partial f(\mathbf{x}^*)

解释:x∗\mathbf{x}^* 是最小点当且仅当零向量是 ff 在 x∗\mathbf{x}^* 处的一个次梯度。

约束优化

考虑约束优化问题:

min⁡xf(x)subject tox∈X\min_{\mathbf{x}} f(\mathbf{x}) \quad \text{subject to} \quad \mathbf{x} \in X

重新表述:引入示性函数 1X(x)1_X(\mathbf{x}),将问题等价写为:

min⁡x{f(x)+1X(x)}\min_{\mathbf{x}} \left\{ f(\mathbf{x}) + 1_X(\mathbf{x}) \right\}

最优性条件:x∗∈X\mathbf{x}^* \in X 是最优解当且仅当:

0∈∂(f(x∗)+1X(x∗))=∇f(x∗)+NX(x∗)0 \in \partial \left( f(\mathbf{x}^*) + 1_X(\mathbf{x}^*) \right) = \nabla f(\mathbf{x}^*) + \mathcal{N}_X(\mathbf{x}^*)

这等价于:

−∇f(x∗)∈NX(x∗)- \nabla f(\mathbf{x}^*) \in \mathcal{N}_X(\mathbf{x}^*)

根据法锥定义,上式等价于:

∇f(x∗)⊤(y−x∗)≥0,∀y∈X\nabla f(\mathbf{x}^*)^\top (\mathbf{y} - \mathbf{x}^*) \geq 0, \quad \forall \mathbf{y} \in X

几何解释:在最优解 x∗\mathbf{x}^* 处,目标函数的梯度指向可行集内部的相反方向,或者说,梯度与从 x∗\mathbf{x}^* 到可行集内任意点的方向成钝角。


次梯度方法 (Subgradient Method)

基本概念

对于凸函数 f:Rd→Rf : \mathbb{R}^d \to \mathbb{R}(不一定可微),次梯度方法模仿梯度下降,但用次梯度代替梯度:

xk+1=xk−ηk+1gkx_{k+1} = x_k - \eta_{k+1} g_k

  • xkx_k:当前点

  • gk∈∇f(xk)g_k \in \nabla f(x_k):ff 在 xkx_k 处的任意一个次梯度

  • ηk>0\eta_k > 0:步长

  • xk+1x_{k+1}:更新后的下一个点

⚠️ 注意:次梯度方法不一定是下降方法。例如 f(x)=∣x∣f(x) = |x| 时,非光滑性会导致振荡。

收敛性定理

定理 3:假设 ff 是凸函数且 L-Lipschitz(即 ∣f(x)−f(y)∣≤L∥x−y∥|f(x) - f(y)| \leq L \|x - y\|)。

  1. 固定步长 ηk=η\eta_k = \eta(对所有 kk):

    lim⁡k→∞f(xbest(k))≤f∗+L2η2\lim_{k \to \infty} f(x_{\text{best}}^{(k)}) \leq f^* + \frac{L^2 \eta}{2}

  2. 递减步长(满足 ∑k=1∞ηk2<∞\sum_{k=1}^\infty \eta_k^2 < \infty 且 ∑k=1∞ηk=∞\sum_{k=1}^\infty \eta_k = \infty):

    lim⁡k→∞f(xbest(k))≤f∗\lim_{k \to \infty} f(x_{\text{best}}^{(k)}) \leq f^*

其中:

  • f(xbest(k))=min⁡i=0,…,kf(xi)f(x_{\text{best}}^{(k)}) = \min_{i=0,\dots,k} f(x_i) 是截至第 kk 步的最优值
  • f∗=f(x∗)f^* = f(x^*) 是真实最小值

证明关键步骤

基于次梯度定义,可推导出基本不等式:

∥xk−x∗∥2≤∥xk−1−x∗∥2−2ηk(f(xk−1)−f∗)+ηk2∥gk−1∥2\|x_k - x^*\|^2 \leq \|x_{k-1} - x^*\|^2 - 2\eta_k (f(x_{k-1}) - f^*) + \eta_k^2 \|g_{k-1}\|^2

迭代该不等式并整理(令 R=∥x0−x∗∥R = \|x_0 - x^*\|),得到:

0≤R2−2∑i=1kηi(f(xi−1)−f∗)+L2∑i=1kηi20 \leq R^2 - 2 \sum_{i=1}^k \eta_i (f(x_{i-1}) - f^*) + L^2 \sum_{i=1}^k \eta_i^2

引入 f(xbest(k))f(x_{\text{best}}^{(k)}) 后,可得基本不等式:

f(xbest(k))−f∗≤R2+L2∑i=1kηi22∑i=1kηif(x_{\text{best}}^{(k)}) - f^* \leq \frac{R^2 + L^2 \sum_{i=1}^k \eta_i^2}{2 \sum_{i=1}^k \eta_i}

不同步长策略的收敛结果均可由此推导。

固定步长下的收敛率

若固定步长为 η\eta,则有:

f(xbest(k))−f∗≤R22kη+L2η2f(x_{\text{best}}^{(k)}) - f^* \leq \frac{R^2}{2k\eta} + \frac{L^2 \eta}{2}

为达到精度 f(xbest(k))−f∗≤εf(x_{\text{best}}^{(k)}) - f^* \leq \varepsilon,可令两项各 ≤ε/2\leq \varepsilon/2,解得:

  • 最优步长:η=εL2\eta = \frac{\varepsilon}{L^2}

  • 所需迭代次数:k=R2L2ε2k = \frac{R^2 L^2}{\varepsilon^2}

因此,次梯度方法的收敛率为 O(1ε2)O\left(\frac{1}{\varepsilon^2}\right)。

📉 对比:梯度下降法在光滑凸函数上的收敛率为 O(1ε)O\left(\frac{1}{\varepsilon}\right),表明次梯度方法收敛更慢。

算法收敛性总结

函数性质 算法 收敛界 迭代次数
凸、L-Lipschitz 次梯度 f(xbest(T))−f∗≤LRTf(x_{\text{best}}^{(T)}) - f^* \leq \frac{LR}{\sqrt{T}} O(R2L2ε2)O\left(\frac{R^2 L^2}{\varepsilon^2}\right)
凸、L-光滑 梯度下降 f(xbest(T))−f∗≤R2L2Tf(x_{\text{best}}^{(T)}) - f^* \leq \frac{R^2 L}{2T} O(R2Lε)O\left(\frac{R^2 L}{\varepsilon}\right)
凸、L-Lipschitz 梯度下降 f(xbest(T))−f∗≤RLTf(x_{\text{best}}^{(T)}) - f^* \leq \frac{RL}{\sqrt{T}} O(R2L2ε2)O\left(\frac{R^2 L^2}{\varepsilon^2}\right)

其中:

  • TT:时间范围/迭代次数
  • R=∥x0−x∗∥R = \|x_0 - x^*\|:初始点与最优点的距离
  • xbest(T)=arg⁡min⁡i=0,1,…,Tf(xi)x_{\text{best}}^{(T)} = \arg\min_{i=0,1,\dots,T} f(x_i):前 TT 次迭代中的最优点

总结

展开

凸函数定义

函数 f:Rd→Rf: \mathbb{R}^d \to \mathbb{R} 是凸函数当且仅当:

  1. 定义域 dom(f)\text{dom}(f) 是凸集;

  2. 对所有 x,y∈dom(f)\mathbf{x}, \mathbf{y} \in \text{dom}(f) 和 λ∈[0,1]\lambda \in [0,1],满足:

    f(λx+(1−λ)y)≤λf(x)+(1−λ)f(y)f(\lambda \mathbf{x} + (1-\lambda)\mathbf{y}) \leq \lambda f(\mathbf{x}) + (1-\lambda)f(\mathbf{y})

几何意义:函数图像上任意两点间的线段位于图像上方。


一阶凸性刻画

若 ff 可微,则凸性等价于:

f(y)≥f(x)+∇f(x)⊤(y−x),∀x,y∈dom(f)f(\mathbf{y}) \geq f(\mathbf{x}) + \nabla f(\mathbf{x})^\top (\mathbf{y} - \mathbf{x}), \quad \forall \mathbf{x}, \mathbf{y} \in \text{dom}(f)

几何意义:函数图像始终在其切超平面的上方。


可微函数

  • 定义:ff 在 x0\mathbf{x}_0 可微当存在梯度 ∇f(x0)\nabla f(\mathbf{x}_0) 使得:

    f(x0+h)≈f(x0)+∇f(x0)⊤hf(\mathbf{x}_0 + \mathbf{h}) \approx f(\mathbf{x}_0) + \nabla f(\mathbf{x}_0)^\top \mathbf{h}

    其中 h\mathbf{h} 为微小扰动。

  • 全局可微:若在定义域内每点可微,则称 ff 可微,其图像在各点有非垂直切超平面。


凸优化问题

形式:

min⁡x∈Rdf(x)\min_{\mathbf{x} \in \mathbb{R}^d} f(\mathbf{x})

其中 ff 是凸可微函数,Rd\mathbb{R}^d 是凸集。全局最小值点记为 x∗=arg⁡min⁡f(x)\mathbf{x}^* = \arg\min f(\mathbf{x})(可能有多个)。


梯度下降法 (Gradient Descent)

核心思想

利用负梯度方向更新参数(梯度 ∇f(x)\nabla f(\mathbf{x}) 指向函数值增长最快的方向):

xk+1=xk−ηk∇f(xk)\mathbf{x}_{k+1} = \mathbf{x}_k - \eta_k \nabla f(\mathbf{x}_k)

  • ηk\eta_k:步长(学习率)

  • xk\mathbf{x}_k:当前参数

收敛性分析

Lipschitz 凸函数(梯度有界)

假设:∥∇f(x)∥≤B\|\nabla f(\mathbf{x})\| \leq B,∥x0−x∗∥≤R\|\mathbf{x}_0 - \mathbf{x}^*\| \leq R
步长选择:η=RBT\eta = \frac{R}{B\sqrt{T}}
收敛速率:

1T∑t=0T−1[f(xt)−f(x∗)]≤RBT\frac{1}{T} \sum_{t=0}^{T-1} [f(\mathbf{x}_t) - f(\mathbf{x}^*)] \leq \frac{RB}{\sqrt{T}}

优势:收敛速率与维度 dd 无关。
实践建议:若 B,RB, R 未知,可尝试小步长(如 η=0.01\eta=0.01)或自适应步长(如 Adam)。

平滑凸函数(梯度 Lipschitz 连续)

定义:ff 是 LL-平滑的当满足:

f(y)≤f(x)+∇f(x)⊤(y−x)+L2∥x−y∥2f(\mathbf{y}) \leq f(\mathbf{x}) + \nabla f(\mathbf{x})^\top (\mathbf{y}-\mathbf{x}) + \frac{L}{2} \|\mathbf{x}-\mathbf{y}\|^2

等价于 ∥∇f(x)−∇f(y)∥≤L∥x−y∥\|\nabla f(\mathbf{x}) - \nabla f(\mathbf{y})\| \leq L \|\mathbf{x}-\mathbf{y}\|。
步长选择:η=1L\eta = \frac{1}{L}
收敛速率:

f(xT)−f(x∗)≤L∥x0−x∗∥22Tf(\mathbf{x}_T) - f(\mathbf{x}^*) \leq \frac{L \|\mathbf{x}_0 - \mathbf{x}^*\|^2}{2T}

对比:平滑函数收敛速率 O(1/ε)O(1/\varepsilon) 优于 Lipschitz 函数的 O(1/ε2)O(1/\varepsilon^2)。
实践建议:若 LL 未知,可通过加倍试探并验证充分下降条件 f(xt+1)≤f(xt)−12L∥∇f(xt)∥2f(\mathbf{x}_{t+1}) \leq f(\mathbf{x}_t) - \frac{1}{2L} \|\nabla f(\mathbf{x}_t)\|^2。


次梯度方法 (Subgradient Method)

次梯度定义

对凸函数 ff,在 x\mathbf{x} 的次梯度 g∈∂f(x)g \in \partial f(\mathbf{x}) 满足:

f(y)≥f(x)+g⊤(y−x),∀yf(\mathbf{y}) \geq f(\mathbf{x}) + g^\top (\mathbf{y} - \mathbf{x}), \quad \forall \mathbf{y}

关键性质:

  • 可微时 ∂f(x)={∇f(x)}\partial f(\mathbf{x}) = \{\nabla f(\mathbf{x})\};
  • 最优性条件:x∗\mathbf{x}^* 是最小点当且仅当 0∈∂f(x∗)0 \in \partial f(\mathbf{x}^*)。

更新规则

xk+1=xk−ηkgk,gk∈∂f(xk)\mathbf{x}_{k+1} = \mathbf{x}_k - \eta_k g_k, \quad g_k \in \partial f(\mathbf{x}_k)

注意:次梯度法非下降方法(例如 f(x)=∣x∣f(x)=|x| 可能振荡)。

收敛性

假设:ff 是 LL-Lipschitz 凸函数

  • 固定步长 η\eta:极限误差 ≤f∗+L2η/2\leq f^* + L^2\eta/2

  • 衰减步长(∑ηk=∞\sum \eta_k = \infty, ∑ηk2<∞\sum \eta_k^2 < \infty):渐近收敛到 f∗f^*
    收敛速率:

f(xbest(k))−f∗≤R2+L2∑i=1kηi22∑i=1kηif(\mathbf{x}_{\text{best}}^{(k)}) - f^* \leq \frac{R^2 + L^2 \sum_{i=1}^k \eta_i^2}{2 \sum_{i=1}^k \eta_i}

其中 R=∥x0−x∗∥R = \|\mathbf{x}_0 - \mathbf{x}^*\|,fbest(k)=min⁡i=0,…,kf(xi)f_{\text{best}}^{(k)} = \min_{i=0,\dots,k} f(\mathbf{x}_i)。